لقد قمت بفحص صفقاتي اليوم، وأجل... يبدو أن الأرباح والخسائر الفعلية لي هذا الأسبوع أسوأ من ثقتي قبل الدخول 😭. لقد كانت حجتي كبيرة على إعداد كان لديه تأكيد ضعيف. نفس الدرس مرة أخرى: إذا كان الإدخال سيئًا، فإن المخرج لا يهم.
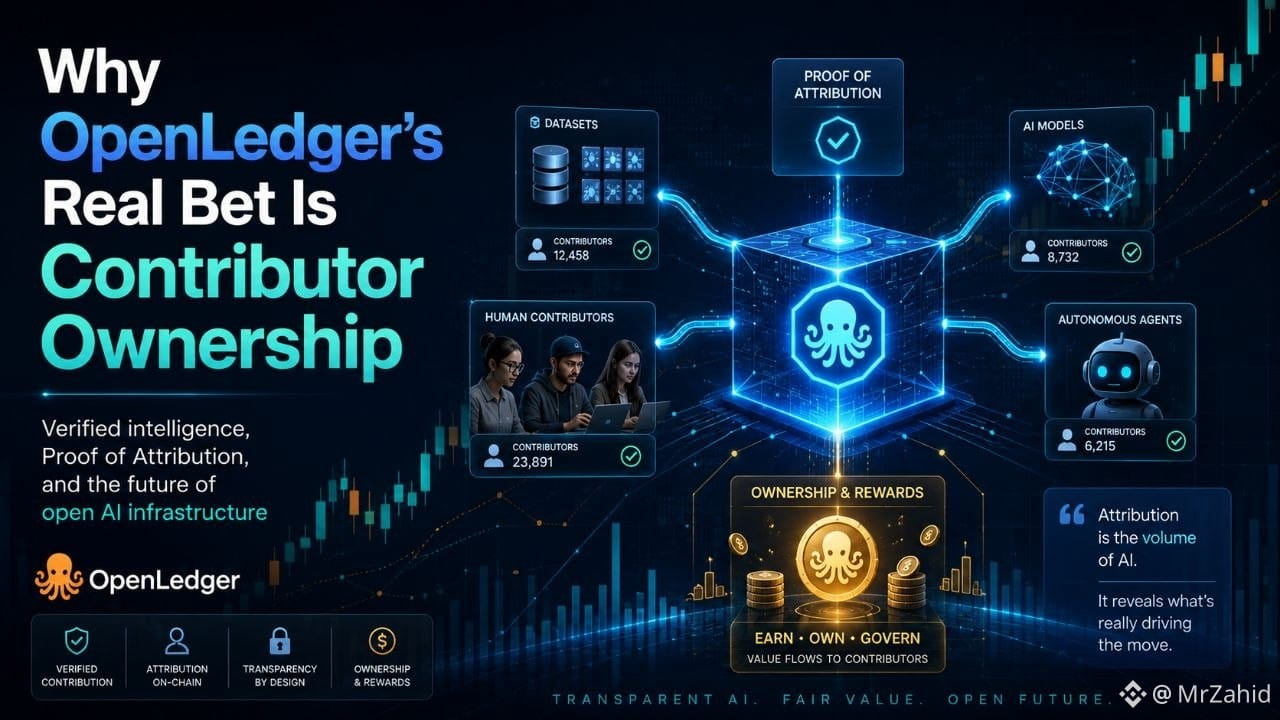
هذا بالضبط هو السبب في أنني أركز على @OpenLedger من زاوية مختلفة الآن. معظم منصات الذكاء الاصطناعي تركز على الجواب النهائي، لكن OpenLedger تركز على المصدر وراء ذلك الجواب. نظامها البيئي مبني حول الذكاء المعتمد، حيث يمكن تتبع مجموعات البيانات والنماذج والعوامل والمساهمين بدلاً من أن تكون مخفية داخل نظام مغلق.
ما لفت انتباهي هو فرضية النظام البيئي: OpenLedger ليست فقط لتطبيق واحد. إنها تضع نفسها كالبنية التحتية لمنشئي الذكاء الاصطناعي الذين يحتاجون إلى التحقق بدون ثقة، وملكية البيانات، وتحقيق الدخل. كما أن استوديو الذكاء الاصطناعي لديهم يقول أيضًا إن المساهمين يمكنهم كسب $OPEN من خلال إثبات النسبة، مما يعني أن القيمة مرتبطة بمساهمة موثقة فعلية، وليس مجرد تفاعل فارغ.
كيف سأقارن ذلك بالتداول: نموذج بدون نسبة يشبه الشارت بدون حجم. قد يبدو نظيفًا، لكنك لا تعرف من يقود الحركة حقًا.
رأيي الحار بسيط. الذكاء الاصطناعي لن يبقى مغلقًا تمامًا إلى الأبد، لأن المبدعين والباحثين ومقدمي البيانات سيطالبون بالاعتماد. إذا استطاعت OpenLedger جعل هذا الاعتماد قابلًا للقياس على السلسلة، فإن #OpenLedger لديه سرد أقوى من مجرد رمز آخر للذكاء الاصطناعي.
إخلاء المسؤولية: هذه ليست نصيحة مالية أو توصية شراء/بيع. أنا أشارك إطار بحثي الشخصي وأسباب قائمة المشاهدة الخاصة بي. أصول التشفير متقلبة، لذا تحقق دائمًا من البيانات الحية وDYOR.