مؤخراً، زودت نفسي بعدد من الأجهزة投入اً في إيكو @OpenLedger ، وقمت بمراجعة دقيقة لعوائد Datanet خلال هذه الفترة، وبصراحة، أصبحت أكثر استقراراً من وقت دخولي الأول. يعتقد الكثيرون أن نقاط البيانات AI بسيطة جداً، وأنه بمجرد تشغيل الأجهزة، ستبدأ حساباتهم التي تحتوي على $OPEN في النمو تلقائياً، لكن هذه الفكرة السلبية للثراء تعتبر حلم يقظة للكثير من الداخلين.
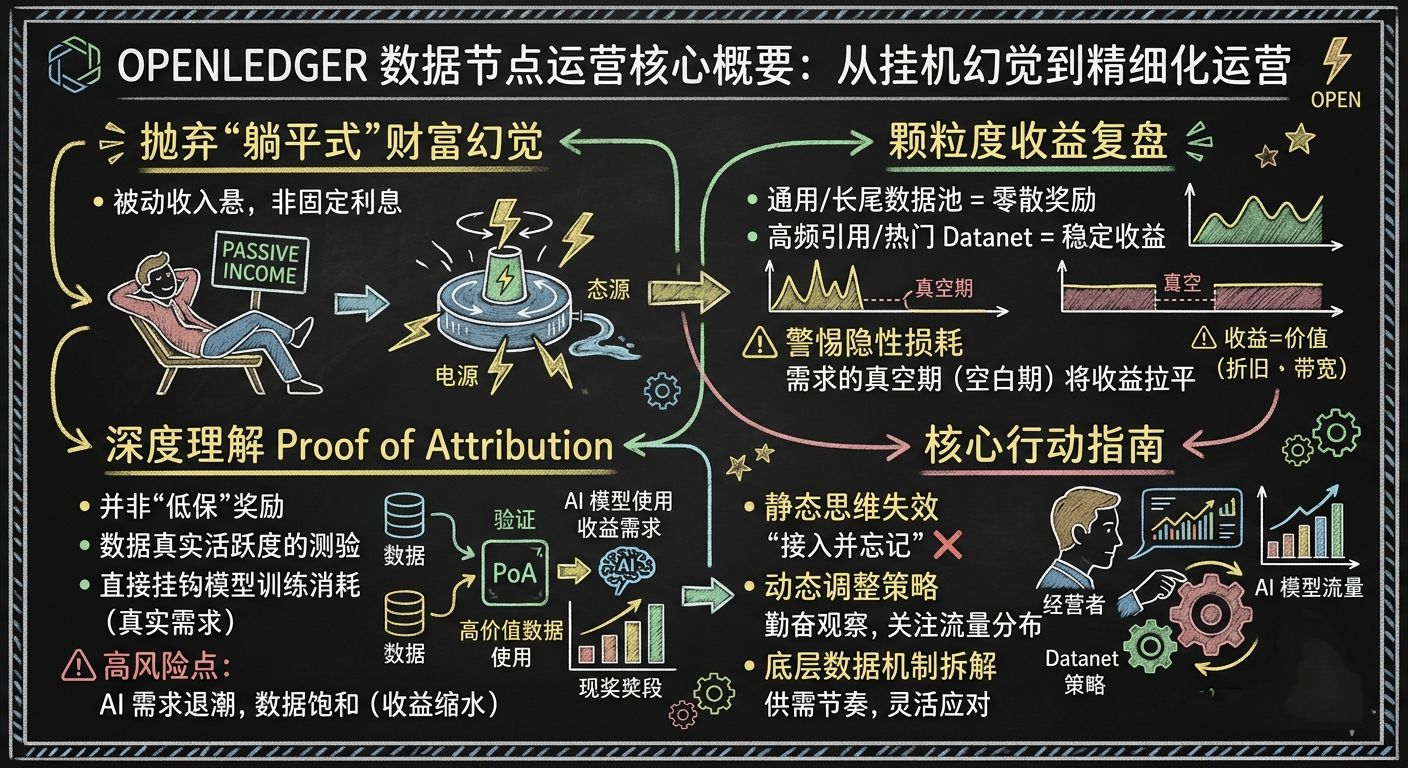
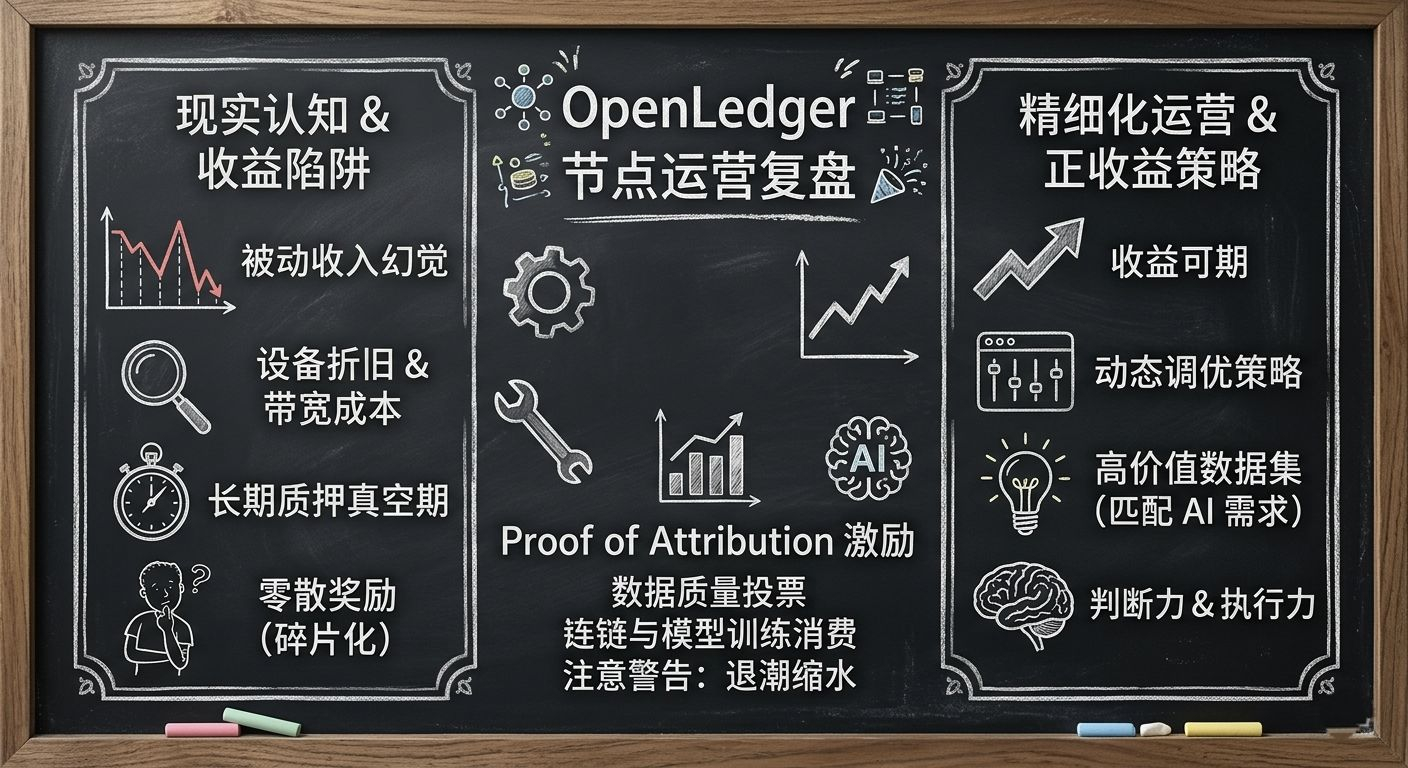
راجعت بعض سجلات التفاعل السابقة، ووجدت أن مجرد السعي لزيادة مدة التشغيل عن طريق الاتصال ببرك البيانات الطويلة والباردة، كانت العوائد المجزأة الناتجة عنها، بعد خصم تكاليف الكهرباء وفقدان الشبكة، شبه مذهلة في انخفاضها. الكثيرون ينجرفون خلف توقعات الإعلانات المجانية، ويتجاهلون أن هذه البيانات ذات الجودة المنخفضة لا تملك فعلياً أي قوة تفاوض في سياق تدريب AI، بل هي مجرد أحمال غير فعالة تساهم بها. إذا كنت ترغب فعلاً في بناء نموذج عائد مستدام في OpenLedger، فإن الأمر يعتمد على فهمك لتمويل البيانات. يجب أن تدرك أن النقاط ليست مجرد أجهزة فيزيائية، بل هي بوابات بيانات تحتاج إلى تحسين ديناميكي. من خلال المقارنة، وجدت أن النقاط التي تستطيع إنتاج عوائد ثابتة تتطابق تماماً مع متطلبات تدريب النماذج السائدة الحالية في Datanet. هناك فجوة معرفية كبيرة هنا: معظم الناس ينظرون فقط إلى APY الحالي، متجاهلين أن حاجة AI لقوة الحوسبة تتقلب بشكل متدرج. إذا لم تقم بإعداد تخزين البيانات قبل ذروة الطلب، فإن عرض النطاق الترددي والقدرة التخزينية لديك في معظم الأوقات ستكون غير فعالة.
دعنا نتحدث عن آلية التحفيز التي تحظى باهتمام كبير في #OpenLedger . من خلال المراقبة الطويلة، أدركت بعمق أن ما يسمى بتوزيع العوائد هو في جوهره تسعير فوري لمجموعات البيانات عالية القيمة من قبل النظام البيئي. إذا لم تتمكن بياناتك من الوصول مباشرة إلى المسارات الحرجة لتعديل النموذج الكبير أو تعزيز البحث، فإن مكافأة الآلية ستقوم بتصفيتها من خلال وزن الخوارزمية، بغض النظر عن مدى طول الوقت الذي تكون فيه النقطة على الإنترنت.
بصراحة، في مسار $OPEN ، استراتيجيات التكوين الثابتة قد فقدت فعاليتها تمامًا. مستقبل الأرباح سيكون فقط لأولئك الذين يعتبرون النقاط مصانع بيانات ويعملون عليها بدقة. تذكر، مكافآت OpenLedger ليست على الإطلاق بناءً على مدة تشغيل أجهزتك، بل تعتمد على قدرتك كمزود بيانات في الحكم والتنفيذ خلال موجة التغيير AI هذه.
راجعت بعض سجلات التفاعل السابقة، ووجدت أن مجرد السعي لزيادة مدة التشغيل عن طريق الاتصال ببرك البيانات الطويلة والباردة، كانت العوائد المجزأة الناتجة عنها، بعد خصم تكاليف الكهرباء وفقدان الشبكة، شبه مذهلة في انخفاضها. الكثيرون ينجرفون خلف توقعات الإعلانات المجانية، ويتجاهلون أن هذه البيانات ذات الجودة المنخفضة لا تملك فعلياً أي قوة تفاوض في سياق تدريب AI، بل هي مجرد أحمال غير فعالة تساهم بها. إذا كنت ترغب فعلاً في بناء نموذج عائد مستدام في OpenLedger، فإن الأمر يعتمد على فهمك لتمويل البيانات. يجب أن تدرك أن النقاط ليست مجرد أجهزة فيزيائية، بل هي بوابات بيانات تحتاج إلى تحسين ديناميكي. من خلال المقارنة، وجدت أن النقاط التي تستطيع إنتاج عوائد ثابتة تتطابق تماماً مع متطلبات تدريب النماذج السائدة الحالية في Datanet. هناك فجوة معرفية كبيرة هنا: معظم الناس ينظرون فقط إلى APY الحالي، متجاهلين أن حاجة AI لقوة الحوسبة تتقلب بشكل متدرج. إذا لم تقم بإعداد تخزين البيانات قبل ذروة الطلب، فإن عرض النطاق الترددي والقدرة التخزينية لديك في معظم الأوقات ستكون غير فعالة.
دعنا نتحدث عن آلية التحفيز التي تحظى باهتمام كبير في #OpenLedger . من خلال المراقبة الطويلة، أدركت بعمق أن ما يسمى بتوزيع العوائد هو في جوهره تسعير فوري لمجموعات البيانات عالية القيمة من قبل النظام البيئي. إذا لم تتمكن بياناتك من الوصول مباشرة إلى المسارات الحرجة لتعديل النموذج الكبير أو تعزيز البحث، فإن مكافأة الآلية ستقوم بتصفيتها من خلال وزن الخوارزمية، بغض النظر عن مدى طول الوقت الذي تكون فيه النقطة على الإنترنت.
بصراحة، في مسار $OPEN ، استراتيجيات التكوين الثابتة قد فقدت فعاليتها تمامًا. مستقبل الأرباح سيكون فقط لأولئك الذين يعتبرون النقاط مصانع بيانات ويعملون عليها بدقة. تذكر، مكافآت OpenLedger ليست على الإطلاق بناءً على مدة تشغيل أجهزتك، بل تعتمد على قدرتك كمزود بيانات في الحكم والتنفيذ خلال موجة التغيير AI هذه.