ألاحظ باستمرار كيف يتحدث الناس عن الذكاء الاصطناعي والكرYPTO وكأنهم يعرفون بالفعل إلى أين تتجه الأمور، وهو أمر غريب لأن معظم هذه البنية التحتية لا تزال تبدو غير مكتملة، تجريبية، تقريبًا غير مستقرة تحت السطح. أحيانًا يبدو الثقة مصطنعة. نظيفة جدًا. مرتبة جدًا. في أسبوع، كل بروتوكول “يبني مستقبل الذكاء”، ثم في الأسبوع التالي، لا يتذكر أحد المشكلة التي كان من المفترض أن تحلها تلك الأنظمة من الأساس. تتحرك الأسواق بسرعة مثل ذلك. تتحرك السرديات بشكل أسرع. لكن تحت كل هذه الضوضاء، لا تزال هناك بعض المشاريع التي تحاول معالجة مشاكل تهم الهيكل بشكل فعلي، وOpenLedger تقع في هذه الفئة، على الرغم من أنني لست متأكدًا تمامًا مما إذا كان السوق يفهم تمامًا ما تحاول أن تصبح.
أو ربما يفهمه السوق تمامًا ولا يهتم بعد.
هذا ممكن أيضًا.
لأن OpenLedger يفرض على الناس الدخول في نقاش أقل إثارة من الذكاء الاصطناعي العام الفائق وأقل إدمانًا عاطفيًا من المضاربات التي تقودها الميمات. إنه يطرح أسئلة عن الملكية، والإسناد، والتنسيق، والمسارات الاقتصادية، والبنية التحتية غير المرئية. ليست موضوعات براقة. وليست من النوع الذي تتجمع حوله عادةً جماهير التجزئة. لكن أحيانًا تنتهي الطبقات الأقل إثارة إلى أن تصبح الأهم لأنها تحدد بهدوء أين تتدفق القيمة تحت كل شيء آخر.
وبصراحة، أعتقد أن صناعة الذكاء الاصطناعي لديها بالفعل مشكلة في الملكية، حتى لو كان معظم المستخدمين مشتتين بجودة المنتج لدرجة لا تتيح لهم ملاحظتها بوضوح. تتدفق البيانات صعودًا إلى الأنظمة المركزية باستمرار. يصبح السلوك البشري مادة تدريبية. تصبح المحادثات مادة تدريبية. تصبح التفضيلات مادة تدريبية. تقوم صناعات كاملة فعليًا بتوليد وقود معلوماتي لأنظمة الذكاء الاصطناعي، بينما تبقى العوائد متركزة حول عدد محدود نسبيًا من الكيانات التي تسيطر على الحوسبة وبنية التوزيع التحتية. يقبل الناس هذا لأن الراحة عادةً ما تنتصر. إنها تنتصر تقريبًا دائمًا. ذلك هو النمط المزعج الذي يتكرر عبر الإنترنت مرة بعد مرة.
يقول المستخدمون إنهم يريدون الملكية إلى أن تُدخل الملكية احتكاكًا.
ثم تسحق الراحة الأيديولوجيا في نحو خمس ثوانٍ.
تعلمت الكريبتو هذا الدرس مرارًا. والذكاء الاصطناعي سيتعلمه على الأرجح أيضًا.
ومع ذلك، يبدو أن OpenLedger ينطلق من افتراض أن اقتصادات الآلات ستصبح في النهاية كبيرة بما يكفي، ومستقلة بما يكفي، وذات أهمية اقتصادية كافية بحيث لا يمكن للإسناد أن يظل غامضًا إلى الأبد. وهذا الافتراض مثير للاهتمام لأنه ينقل النقاش بعيدًا عن ضجيج الذكاء الاصطناعي نحو المساءلة الاقتصادية. بمجرد أن تبدأ وكلاء الذكاء الاصطناعي في توليد القيمة بشكل مستقل، يتوقف السؤال عن كونه "ما مدى ذكاء النموذج؟" ويبدأ في التحول إلى "من يتقاضى الأجر عندما ينتج النموذج شيئًا ذا قيمة؟"
ذلك يبدو مملًا في البداية.
إلى أن تفكر في الأمر لفترة أطول.
لأن النظام بأكمله يصبح فجأة فوضويًا.
تخيل وكلاء ذكاء اصطناعي مستقلين يجرون الأبحاث، ويكتبون الشيفرة، ويديرون الخدمات اللوجستية، وينتجون الوسائط، وينفذون القرارات المالية، ويتفاوضون على العقود، وربما حتى يديرون الأعمال في النهاية. إذا كانت تلك الأنظمة مُدرَّبة على مجموعات بيانات موزعة ساهم فيها ملايين الأشخاص أو المؤسسات أو الآلات، فكيف تتتبع المساهمة الاقتصادية بالضبط؟ كيف تقيس التأثير؟ كيف تتحقق من الأصل؟ وربما أصعب سؤال على الإطلاق: كيف تمنع طبقة الحوافز نفسها من الانهيار إلى التلاعب بمجرد أن تصبح الإسنادات ذات قيمة مالية؟
ذلك الجزء الأخير يستمر في جذبي للعودة إليه لأن البشر يمكن التنبؤ بهم بشكل مذهل بمجرد دخول المكافآت في المعادلة. كل نظام حوافز يعلم الناس في النهاية كيف يستغلونه. إنه أمر يكاد يكون حتميًا. امتلأ الإنترنت بالاصطياد من أجل التفاعل لأن الخوارزميات كافأت الانتباه. وامتلأت الكريبتو بالمرتزقة الباحثين عن السيولة لأن البروتوكولات كافأت المشاركة قصيرة الأجل. وستمر أنظمة إسناد الذكاء الاصطناعي على الأرجح بنسختها الخاصة من هذا. مجموعات بيانات مصطنعة تتظاهر بأنها ذات قيمة. تلاعب منسق. هجمات سيبيل. مساهمات مسمومة متخفية في صورة معلومات مفيدة. نشاط زائف مُحسَّن بالكامل للاستخراج.
وبصراحة، أعتقد أن كثيرًا من بروتوكولات الذكاء الاصطناعي تقلل من تقدير مدى عدوانية هذه السلوكيات بمجرد ظهور الحوافز الاقتصادية الحقيقية.
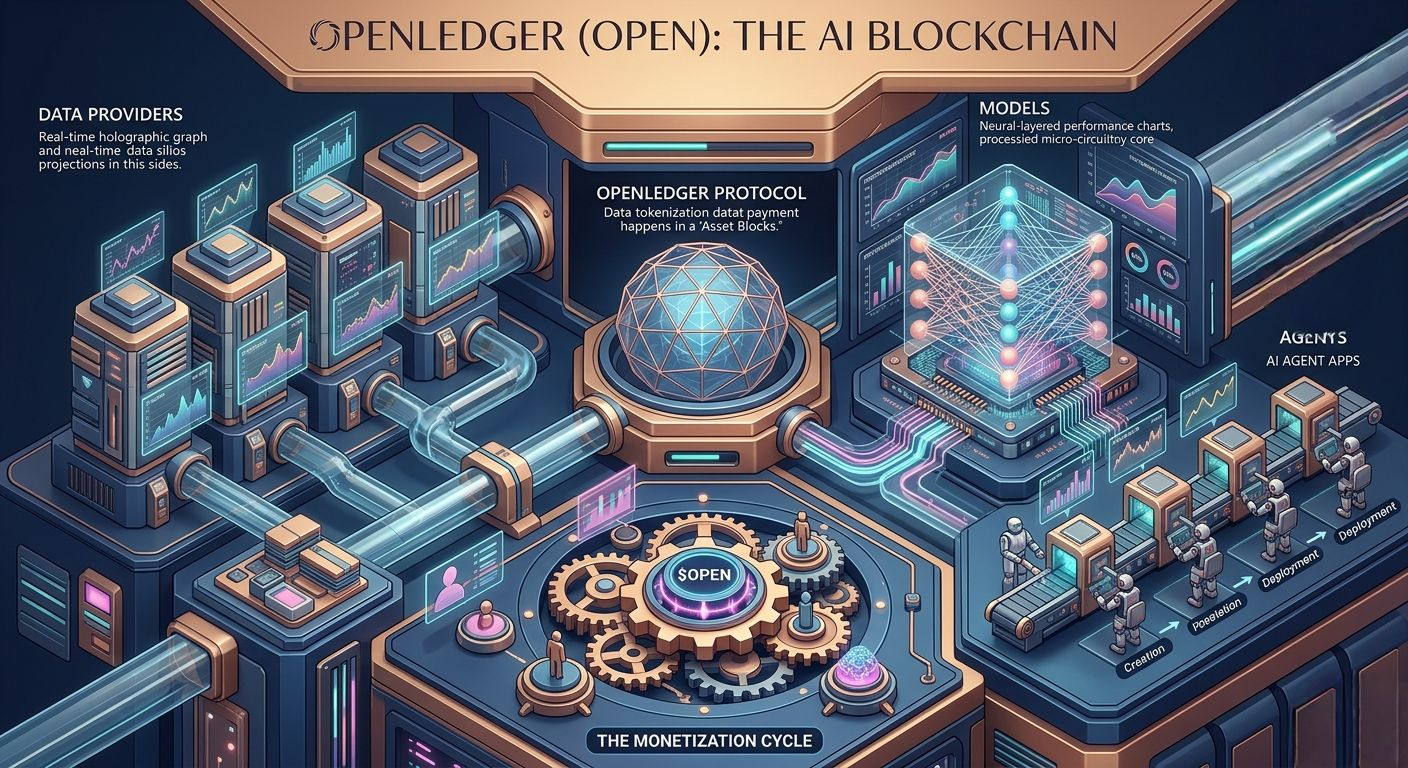
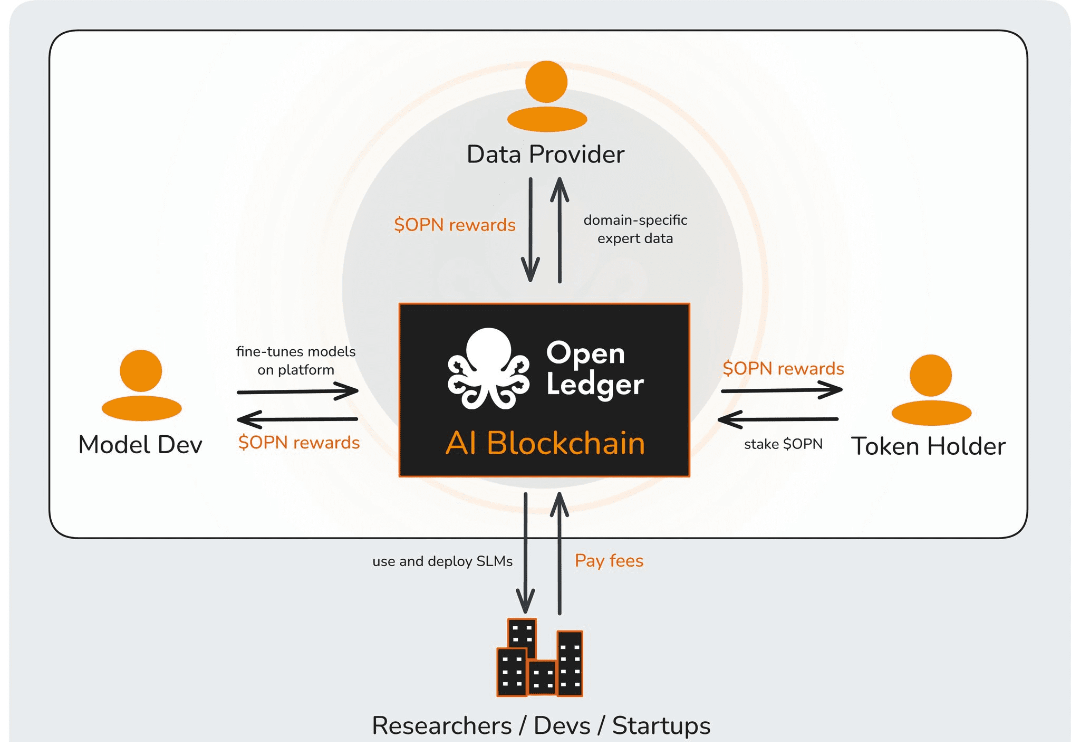
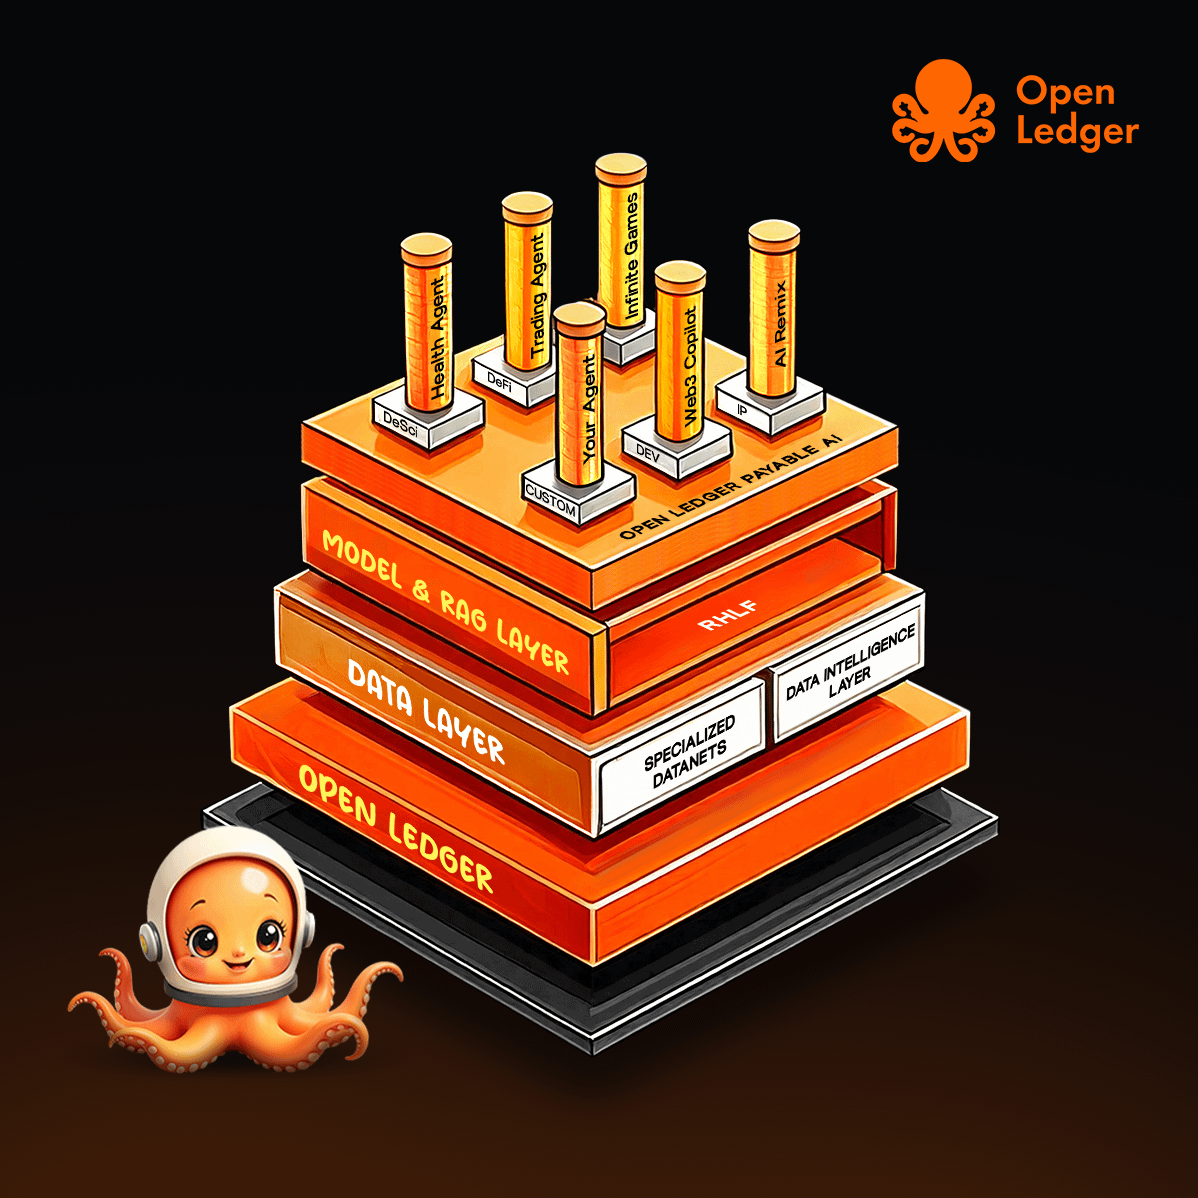
يحاول OpenLedger التعامل مع هذا من خلال إطار Proof of Attribution وبنية Datanet، وهو في الأساس محاولة لتحويل مساهمات البيانات إلى أصول اقتصادية قابلة للتتبع مرتبطة بتوليد مخرجات الذكاء الاصطناعي. وعلى المستوى المفاهيمي، يبدو المنطق معقولًا. إذا أنتج نموذج قيمة باستخدام مدخلات معلوماتية موزعة، فينبغي نظريًا أن يشارك المساهمون في العائد الاقتصادي المرتبط بتلك المخرجات. يحاول البروتوكول تقنين تلك العلاقة بدلًا من تركها بالكامل داخل هياكل الشركات الغامضة.
فكرة بسيطة.
واقع معقد.
لأن الإسناد داخل تعلم الآلة ليس رياضيات نظيفة. النماذج تمتص الأنماط احتماليًا عبر فضاءات ضخمة من المعلمات. يصبح التأثير غير خطي. قد يغير عنصر بيانات غامض واحد السلوك بشكل كبير بينما تكاد ملايين المدخلات الأخرى لا تهم على الإطلاق. محاولة عزل المساهمة الدقيقة داخل الأنظمة العصبية قد تبدو شبه مستحيلة أحيانًا. ليست مستحيلة نظريًا ربما، لكنها قبيحة تشغيليًا. ومكلفة أيضًا.
هذا شيء آخر يتجنبه الناس مناقشته بما يكفي.
العبء الحاسوبي.
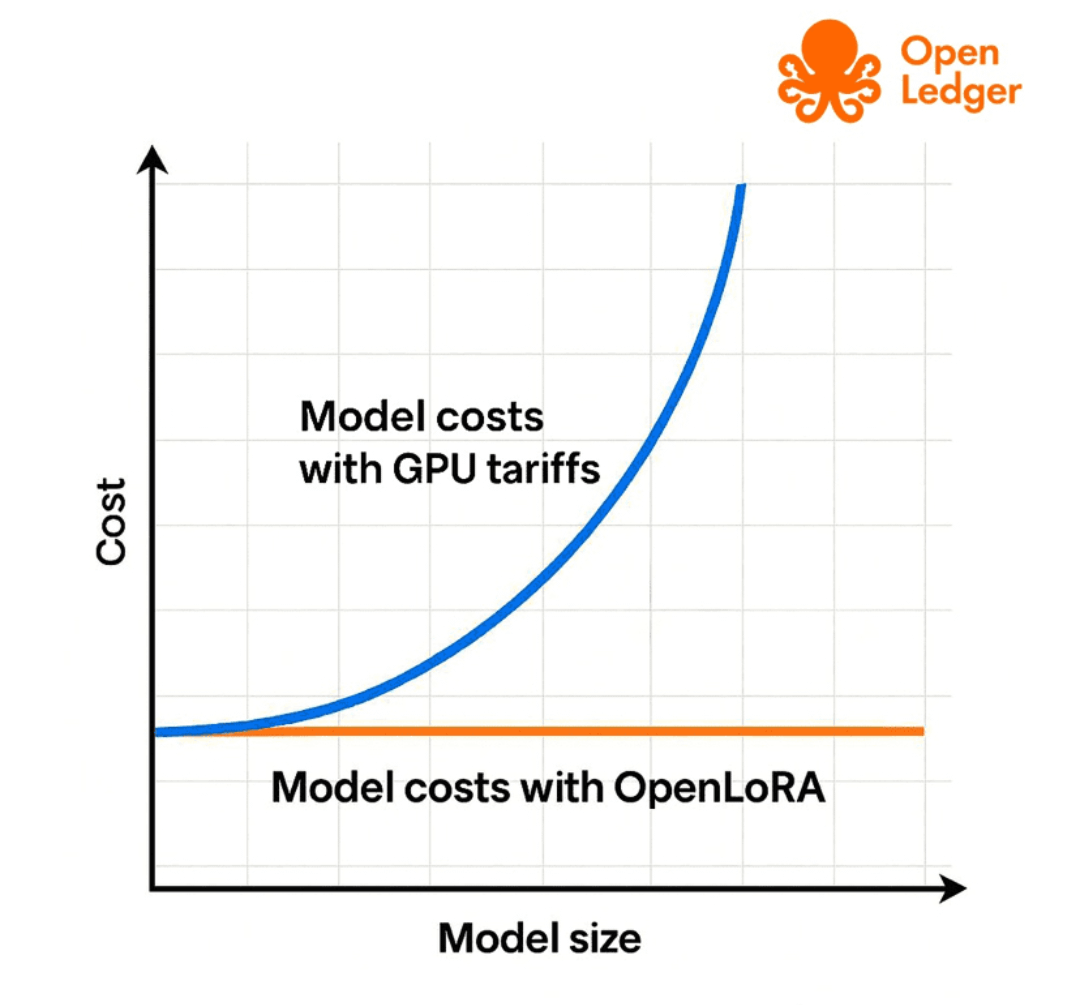
تستهلك بنية الذكاء الاصطناعي التحتية بالفعل موارد هائلة قبل أن تدخل اللامركزية في الصورة. تدريب النماذج مكلف. وتشغيل الاستدلال على نطاق واسع مكلف. والتخزين مكلف. وطبقات التحقق تضيف عبئًا إضافيًا. وتضيف سلاسل الكتل زمن تأخير. وتستهلك أنظمة التحقق موارد أكثر. كل ضمان للثقة يخلق مقاومة تشغيلية في مكان ما داخل المعمارية، وهنا غالبًا ما تصطدم خيالية اللامركزية بلا احتكاك بالواقع المادي.
أنظمة الذكاء الاصطناعي تُحسن الكفاءة بطبيعتها.
تُحسّن سلاسل الكتل بشكل طبيعي من التحقق.
تلك الأهداف لا تتطابق تمامًا. أحيانًا تتصارع فعليًا مع بعضها.
وأعتقد أن OpenLedger يفهم هذا التوتر أفضل من بعض السرديات الأعلى صوتًا حول الذكاء الاصطناعي المنتشرة الآن في عالم الكريبتو. على الأقل يبدو البروتوكول أكثر تركيزًا على البنية التحتية الاقتصادية وآليات الإسناد بدلًا من التظاهر بأن اللامركزية تزيل قيود الهندسة سحرًا. إنها لا تفعل ذلك. ما تزال الفيزياء موجودة. وما يزال ندرة الحوسبة موجودة. وما تزال قيود النطاق الترددي موجودة. أحيانًا يتحدث الإنترنت عن اللامركزية كما لو كانت تعويذة أخلاقية قادرة على حل كل مشكلة تنسيق تلقائيًا. لكنها ليست كذلك. تبقى المقايضات حتمية.
دائمًا.
ربما لهذا أجد البروتوكول أكثر إثارة من منظور المبادئ الأولى منه من منظور المضاربة. لأن المشكلة الحقيقية هنا ليست ما إذا كان الذكاء الاصطناعي سيصبح لامركزيًا بمعنى أيديولوجي خالص. المشكلة الحقيقية هي ما إذا كانت اقتصادات الآلات المستقبلية ستتطلب طبقات تنسيق قابلة للتدقيق بمجرد أن تبدأ الأنظمة المستقلة بالتفاعل ماليًا مع بعضها البعض على نطاق واسع.
وأعتقد أنهم يفعلون ذلك على الأرجح.
ليس لأن اللامركزية تبدو نبيلة.
لأن الأنظمة الغامضة تنشئ في النهاية عدم استقرار اقتصادي عندما يمر عبرها قدر كافٍ من القيمة.
تخيل وكلاء ذكاء اصطناعي يتعاملون باستمرار عبر الأسواق المالية، وسلاسل الإمداد، وأنظمة الرعاية الصحية، والبنية التحتية القانونية، وعمليات الشركات. عند نقطة ما، يصبح الأصل أكثر من مجرد شاغل فلسفي. إنه يصبح بنية محاسبية. تهتم المؤسسات بالتتبع عندما تظهر المسؤولية. وتهتم الشركات بإمكانية التدقيق عندما تنتقل الأموال. وتهتم الحكومات عندما يدخل الامتثال في الحديث. فجأة تتوقف أنظمة الإسناد عن الظهور كخيار ثانوي.
ذلك الاحتمال يبدو مهمًا.
لكن هناك جانبًا آخر لهذا الأمر يزعجني قليلًا.
ربما لن يهتم المستخدمون ببساطة.
ربما يظل الذكاء الاصطناعي المركزي شديد الكفاءة، شديد الراحة، وأفضل تشغيليًا لدرجة أن الناس يبدلون الشفافية بالأداء طوعًا إلى ما لا نهاية. لن يكون ذلك غير مسبوق. معظم مستخدمي الإنترنت يعتمدون بالفعل على أنظمة بالكاد يفهمونها. للراحة قدرة مرعبة على تطبيع الغموض بمرور الوقت. نادرًا ما يفحص الناس البنية التحتية غير المرئية إلا إذا فشلت بشكل كارثي.
وبطريقة غريبة، فإن OpenLedger يراهن ضد هذا الرضا عن النفس.
أو ربما ليس ضده تمامًا. ربما يراهن البروتوكول على أنه حتى لو ظل المستخدمون العاديون غير مبالين، فإن اقتصادات الآلات نفسها ستحتاج في النهاية إلى طبقات للمساءلة تحت السطح، سواء لاحظها البشر بوعي أم لا. هذه أطروحة أكثر دقة. أقل أيديولوجية. وأكثر بنيوية.
المفارقة هي أن البنية التحتية الناجحة غالبًا ما تصبح غير مرئية. لا أحد يفكر في مسارات الدفع أثناء معاملة عادية. لا أحد يفكر في أنظمة DNS أثناء تصفح الإنترنت. لا أحد يفكر في تنسيق السحابة أثناء بث الوسائط. تختفي البنية التحتية بمجرد أن تعمل بشكل موثوق بما يكفي. ربما تتطور أنظمة الإسناد بالطريقة نفسها في النهاية. طبقات تنسيق هادئة تحت اقتصادات تقودها الآلات، تعمل باستمرار بينما يتفاعل المستخدمون فقط مع التطبيقات المصقولة التي تعلوها.
إذا حدث ذلك، فقد تصبح بروتوكولات مثل OpenLedger أهم مما يفترضه الناس حاليًا.
أو ربما تفشل بالكامل لأن التعقيد التشغيلي يصبح طاغيًا.
لا ينبغي تجاهل هذا الاحتمال أيضًا.
هناك مخاطر حقيقية في كل مكان هنا. أنظمة الحوافز المرمّزة تجذب غالبًا سلوك الاستخراج قبل السلوك المنتج. يمكن أن تشوه الانتباهات المضاربية أولويات تطوير البنية التحتية. تصبح هياكل الحوكمة عرضة للتركيز. تصبح آليات التحقق من البيانات صعبة التوسع بعدل. يمكن التلاعب بأنظمة السمعة. قد تصبح مقاييس الإسناد قابلة للاستغلال اقتصاديًا بطرق لا يتوقعها أحد بالكامل في البداية.
وبصراحة، ما تزال هناك حالة من عدم اليقين الأوسع معلقة فوق قطاع الذكاء الاصطناعي بأكمله. لا أحد يعرف حقًا ما هو الشكل المعماري المهيمن لاقتصادات الآلات المستقبلية حتى الآن. الهياكل النموذجية تتغير باستمرار. وكفاءة العتاد تتطور. والضغط التنظيمي يتبدل. يمكن أن تبدو افتراضات كاملة حول التدريب والاستدلال والملكية قديمة بسرعة مدهشة. البنية التحتية المبنية مبكرًا جدًا تحل أحيانًا مشكلات مؤقتة بدلًا من المشكلات الدائمة.
ذلك الخطر يبدو حقيقيًا.
لكن الانتظار طويلًا جدًا يخلق مشكلة مختلفة، لأن اللاعبين المركزيين الراسخين يرسخون السيطرة بينما يتردد الآخرون.
لذلك توجد هذه البروتوكولات في منطقة وسطى محرجة، حيث تحاول بناء أنظمة لاقتصادات لم توجد بالكامل بعد. ذلك أرض خطرة. والمضاربة على البنية التحتية دائمًا كذلك. كانت السكك الحديدية مضاربة يومًا ما. وبدا البنيان المبكر للإنترنت غير عقلاني يومًا ما. وكان الحوسبة السحابية تبدو غير ضرورية يومًا ما. أحيانًا تبدو الأنظمة المهمة عبثية اقتصاديًا قبل أن ينضج المحيط بما يكفي لتبريرها.
وفي أحيان أخرى، تفشل ببساطة.
الأمر الصعب هو التمييز بينهما مبكرًا.
وربما هذا اللايقين بالضبط هو السبب في أن الحديث حول بنية الذكاء الاصطناعي التحتية يبدو غريبًا جدًا الآن. يتحدث الناس عن الحتمية باستمرار رغم أن كل شيء تقريبًا ما يزال غير محسوم تحت السطح. الملكية غير محسومة. الإسناد غير محسوم. لامركزية الحوسبة غير محسومة. تصميم الحوافز غير محسوم. الحوكمة غير محسومة. القيود السلوكية غير محسومة. ومع ذلك تبقى الثقة عالية بشكل غريب، ربما لأن الأسواق تكافئ اليقين حتى عندما يكون ذلك اليقين مصطنعًا.
شخصيًا أثق بالأنظمة أكثر عندما تعترف بصراحة بالمقايضات التشغيلية بدلًا من التظاهر بأن الكمال موجود على بُعد خطوة.
المرونة أهم من الكمال.
لقد كان كذلك دائمًا.
لا يحتاج النظام إلى القضاء على كل عيب حتى يصبح مفيدًا. يكفي أن يظل عمليًا تحت الضغط بينما يحل مشكلة تنسيق حقيقية بشكل أفضل من البدائل القائمة. تلك العتبة مهمة. وعلى الأقل يبدو أن OpenLedger يركز على مشكلة تنسيق تبدو فعلًا مهمة بنيويًا بدلًا من أن تكون مثيرة للإعجاب شكليًا.
من يملك القيمة التي تنتجها الآلات؟
ذلك السؤال يزداد حجمًا كلما تقدم الذكاء الاصطناعي أكثر.
لأن الذكاء، بمجرد أن يصبح منتجًا اقتصاديًا على نطاق واسع، يتوقف الإسناد عن كونه فلسفة مجردة. إنه يصبح بنية مالية. الأنظمة التي تتتبع التأثير المعلوماتي قد تحدد بهدوء من يستحوذ على القيمة تحت الجيل القادم من الاقتصادات الرقمية.
وربما لن يلاحظ معظم الناس ذلك حتى الآن.
ربما تصبح الواجهات سلسة جدًا لدرجة أن المستخدمين لا يفكرون أبدًا في البنية التحتية تحتها. ربما تعمل اقتصادات الذكاء الاصطناعي على مسارات إسناد غير مرئية بالطريقة نفسها التي يعمل بها التمويل الحديث اليوم على أنظمة تسوية غير مرئية. آلات هادئة. حركة مستمرة. اهتمام عام ضئيل جدًا إلى أن ينكسر شيء ما.
أو ربما تنتصر الراحة مرة أخرى وتمتص النماذج المركزية كل شيء بشكل دائم لأن المستخدمين يفضلون النتائج على هياكل الملكية.
بصراحة، لست مقتنعًا تمامًا أيضًا بأن أيًا من السيناريوهين مستحيل.
هذا على الأرجح هو الموقف الأكثر واقعية الآن.
اللايقين.
ليس اليقين المصقول الذي يحب السوق أن يصنعه، بل النوع المزعج الذي تبقى فيه عدة مستقبلات ممكنة في الوقت نفسه. يبدو OpenLedger كأنه محاولة للاستعداد لأحد تلك المستقبلات قبل أن يصل بالكامل. ربما مبكرًا. ربما ضروريًا. ربما كلاهما.
وهناك شيء إنساني بشكل غريب في ذلك، حتى داخل كل هذا الحديث عن البنية التحتية الآلية. يستمر الناس في بناء أنظمة لحل مشكلات لم تتجسد بالكامل بعد، لأن انتظار اليقين يعني عادة الوصول متأخرًا جدًا. أحيانًا تعيد تلك الرهانات تشكيل صناعات كاملة. وأحيانًا تختفي بهدوء تحت معماريات أحدث لم يتنبأ بها أحد.
لكن التوتر الأساسي يبقى مهما كان الأمر.
الراحة مقابل الملكية.
الكفاءة مقابل التحقق.
الغموض مقابل المساءلة.
سيجبر الذكاء الاصطناعي هذا الصراع على الخروج إلى العلن في نهاية المطاف.
لا أعتقد أننا مستعدون لمدى الفوضى التي تصبح عليها تلك العملية بمجرد أن يبدأ النفوذ الاقتصادي الحقيقي بالتدفق عبر الأنظمة المستقلة على نطاق واسع.
ربما تكون بروتوكولات مثل OpenLedger لمحات مبكرة من البنية التحتية التي تحاول الاستعداد لهذا الواقع قبل أن يدرك بقية الإنترنت أنه يحدث بالفعل.
@OpenLedger #OpenLedger $OPEN