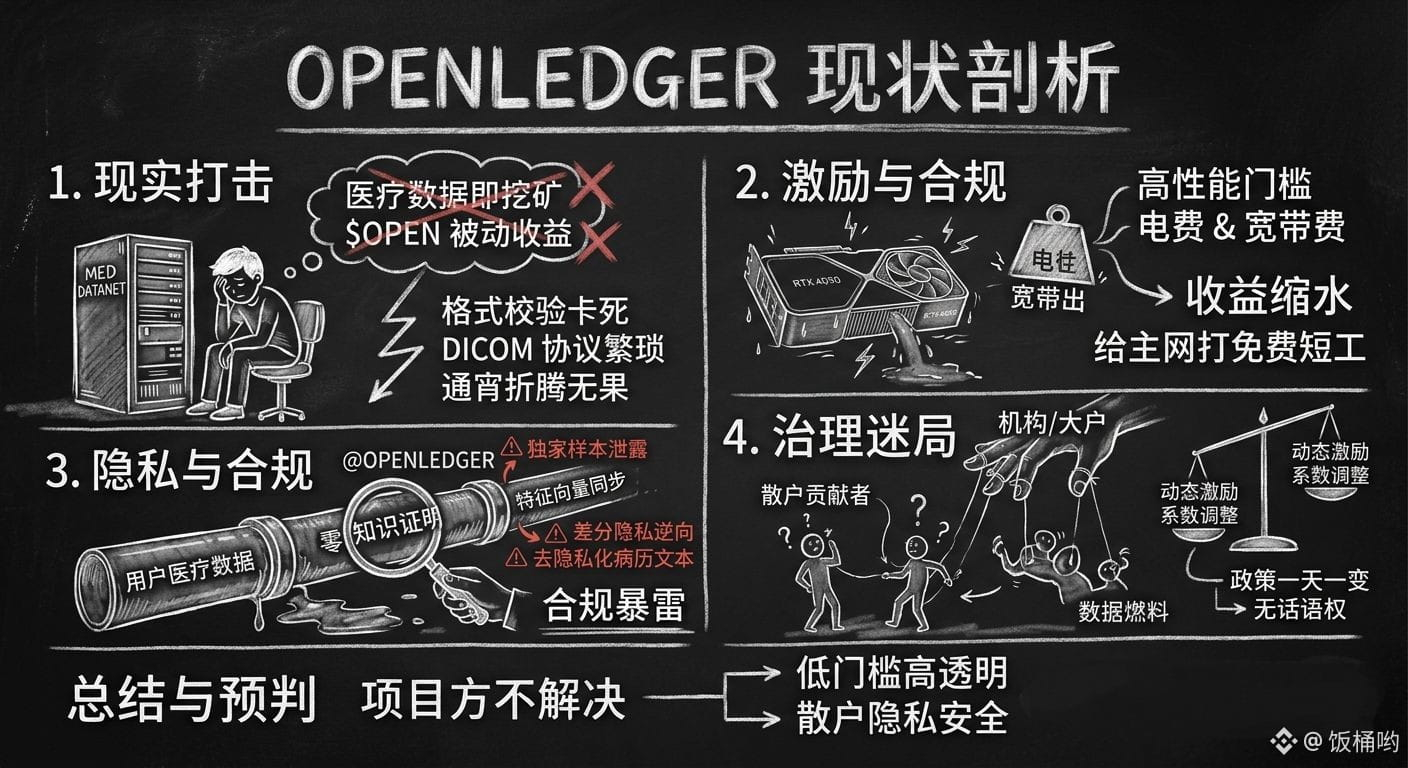
قبل يومين كنت أشوف في الساحة الناس تتكلم عن منصة @OpenLedger لتعليم الصور الطبية بالذكاء الاصطناعي، فقررت أحمس نفسي وأرفع مجموعة بيانات مرض الجلد اللي جمعتها في الاستوديو على Med DataNet. النتيجة؟ قضيت ليلة كاملة أحاول، علقني في خطوة التحقق من التنسيق، وصرت أواجه مجموعة معقدة من بروتوكولات تحويل DICOM ومنطق التوافق مع العلامات، تقريبًا خلتني أتوتر.
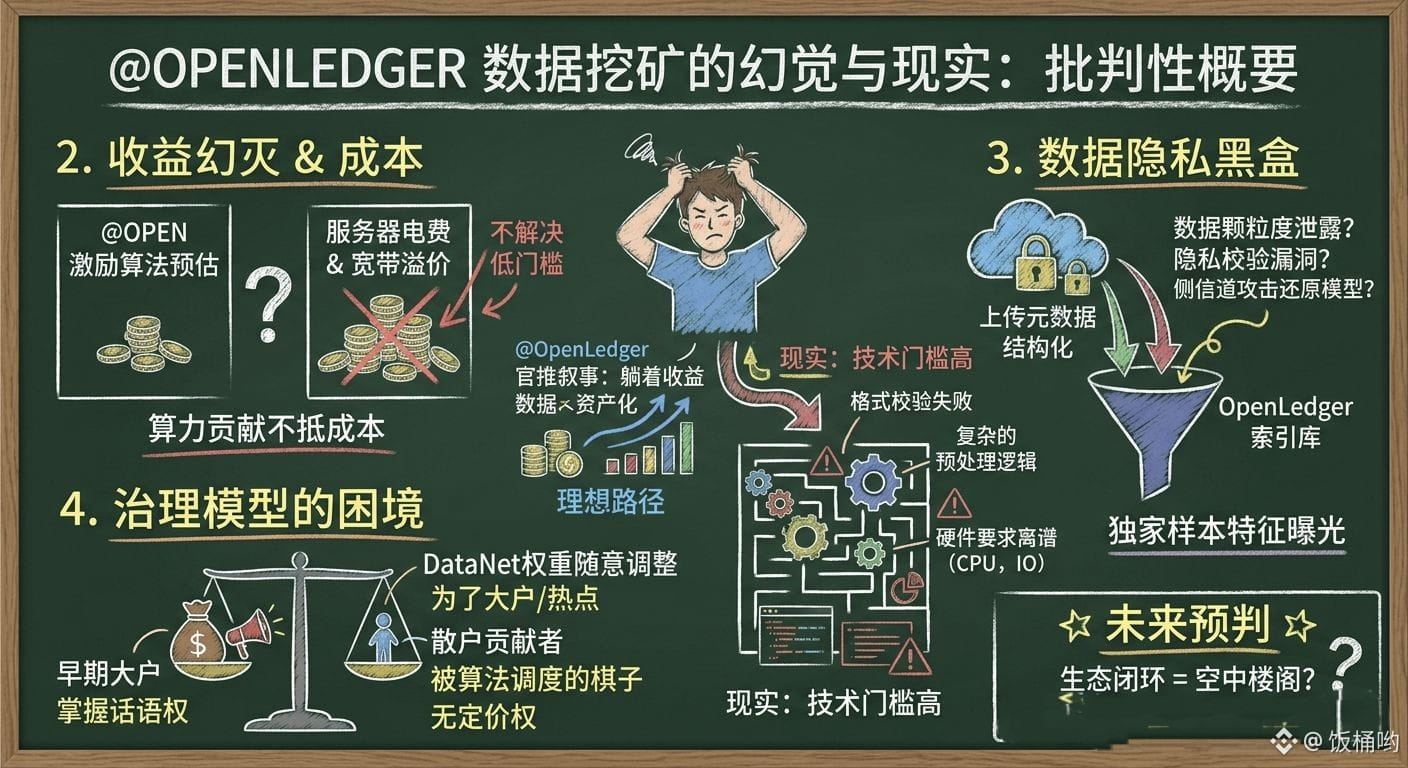
أعترف أني انخدعت بالشعارات الكبيرة عن بيانات الطب والـ Mining اللي قدموها، كنت أتصور أني لو رفعت الأصول المخزنة عندي ممكن أجني منها إيرادات سلبية تصل لـ $OPEN . لكن لما جيت أركب عقد التحقق، الواقع كان صدمة. الوثائق الرسمية تسمي هذا منخفض السعر للبناء المشترك، لكن في الحقيقة المتطلبات للذاكرة العميقة وعرض النطاق الترددي كانت مرعبة. استخدمت محطة العمل الخاصة بي من نوع 4090 لمدة ثلاثة أيام، وحسبت بناءً على أحدث صيغة تحفيزية عندهم، وبعد خصم تكاليف الكهرباء والإنترنت التجارية، كان نصيبي من $OPEN يكفي لشراء فنجان قهوة، وصرت أعمل كأنني عمالة مجانية على الشبكة الرئيسية.
أكثر من تقلص الأرباح، اللي يخوف هو الفوضى في حقوق البيانات الأساسية والامتثال. @OpenLedger يتفاخر دائمًا بإثبات المعرفة الصفرية وتقنيات التشفير المتجانسة، ويقولون إنهم قادرين على جعل البيانات قابلة للاستخدام ولكن غير مرئية. لكن في الواقع، عشان تحصل على وزن تحفيزي عالي، لازم تجمع بين متجهات ميزات البيانات ونصوص السجلات الطبية المزالة الخصوصية. رغم إن البيانات الطبية تُقال إنها مخزنة بشكل لامركزي وبدون هوية، لكن مين يضمن أن نقاط توجيه مستوى البحث ما تتعرض للاختراق عبر الهندسة العكسية للخصوصية التفاضلية؟ إذا صار تسرب لنماذج حصرية، مو إحنا اللي بنتحمل المسؤولية كمنقبين رقميين قدمنا البيانات؟ #OpenLedger
الأكثر إحباطًا هو جو إدارة المجتمع الحالي لـ $OPEN ، السياسات تتغير يوميًا، وإحنا كمتداولين صغار حتى ما عندنا حق المعرفة، ناهيك عن حق الكلام، باختصار، نحن مجرد وقود يقطعه المتداولون الكبار. الآن صرت أشوف الأمور بوضوح، @OpenLedger هل فعلاً بيغير طريقة توزيع موارد الإنتاج في الذكاء الاصطناعي، أو مجرد يتلاعب تحت مظلة الذكاء الاصطناعي اللامركزي ليخلق دورة جديدة من الوعود الوهمية؟ النقاش هنا ما يحتاج، إذا ما أخذ المشروع خصوصية وسلامة المستثمرين الصغار وأرباحهم بجدية، وبس يعتمد على شوية كبار يتداولون في المجتمع، فهذي السردية المسماة Web3+AI ما هي إلا سراب.
أعترف أني انخدعت بالشعارات الكبيرة عن بيانات الطب والـ Mining اللي قدموها، كنت أتصور أني لو رفعت الأصول المخزنة عندي ممكن أجني منها إيرادات سلبية تصل لـ $OPEN . لكن لما جيت أركب عقد التحقق، الواقع كان صدمة. الوثائق الرسمية تسمي هذا منخفض السعر للبناء المشترك، لكن في الحقيقة المتطلبات للذاكرة العميقة وعرض النطاق الترددي كانت مرعبة. استخدمت محطة العمل الخاصة بي من نوع 4090 لمدة ثلاثة أيام، وحسبت بناءً على أحدث صيغة تحفيزية عندهم، وبعد خصم تكاليف الكهرباء والإنترنت التجارية، كان نصيبي من $OPEN يكفي لشراء فنجان قهوة، وصرت أعمل كأنني عمالة مجانية على الشبكة الرئيسية.
أكثر من تقلص الأرباح، اللي يخوف هو الفوضى في حقوق البيانات الأساسية والامتثال. @OpenLedger يتفاخر دائمًا بإثبات المعرفة الصفرية وتقنيات التشفير المتجانسة، ويقولون إنهم قادرين على جعل البيانات قابلة للاستخدام ولكن غير مرئية. لكن في الواقع، عشان تحصل على وزن تحفيزي عالي، لازم تجمع بين متجهات ميزات البيانات ونصوص السجلات الطبية المزالة الخصوصية. رغم إن البيانات الطبية تُقال إنها مخزنة بشكل لامركزي وبدون هوية، لكن مين يضمن أن نقاط توجيه مستوى البحث ما تتعرض للاختراق عبر الهندسة العكسية للخصوصية التفاضلية؟ إذا صار تسرب لنماذج حصرية، مو إحنا اللي بنتحمل المسؤولية كمنقبين رقميين قدمنا البيانات؟ #OpenLedger
الأكثر إحباطًا هو جو إدارة المجتمع الحالي لـ $OPEN ، السياسات تتغير يوميًا، وإحنا كمتداولين صغار حتى ما عندنا حق المعرفة، ناهيك عن حق الكلام، باختصار، نحن مجرد وقود يقطعه المتداولون الكبار. الآن صرت أشوف الأمور بوضوح، @OpenLedger هل فعلاً بيغير طريقة توزيع موارد الإنتاج في الذكاء الاصطناعي، أو مجرد يتلاعب تحت مظلة الذكاء الاصطناعي اللامركزي ليخلق دورة جديدة من الوعود الوهمية؟ النقاش هنا ما يحتاج، إذا ما أخذ المشروع خصوصية وسلامة المستثمرين الصغار وأرباحهم بجدية، وبس يعتمد على شوية كبار يتداولون في المجتمع، فهذي السردية المسماة Web3+AI ما هي إلا سراب.