$OPEN
#OpenAIToConfidentiallyFileForIPO OpenLedger والشعور الغريب بأن الذكاء الاصطناعي قد يصل أخيرًا إلى نفس الحائط.
لقد كنت في عالم العملات الرقمية لفترة كافية لأتوقف عن التفاعل في كل مرة يدعي فيها مشروع أنه "يعيد تعريف" شيء ما.
في معظم الأحيان، هذه الكلمات ليست سوى تغليف معاد حول نفس الحوافز القديمة. رمز جديد، علامة تجارية جديدة، نفس الواقع الأساسي: بعض المطلعين يلتقطون القيمة، والجموع توفر السيولة، وفي النهاية تتحرك الرواية إلى مكان آخر.
ربما لهذا السبب أصبحت أبطأ في الانفعال بشأن أي شيء مرتبط بالذكاء الاصطناعي مؤخرًا. يبدو أن المساحة مزدحمة بالفعل بوعود ضخمة. كل أسبوع هناك بروتوكول آخر يدعي أنه سيقوم بلامركزية الذكاء، توكين agents، إعادة اختراع الحوسبة، أو استبدال الإنترنت نفسه. بعد فترة، يندمج كل ذلك في نفس الضجيج الخلفي.
لكن بين الحين والآخر، يلفت انتباهي شيء ما، ليس لأنني فجأة أؤمن به، ولكن لأنه يبدو مركزًا على مشكلة موجودة بالفعل.
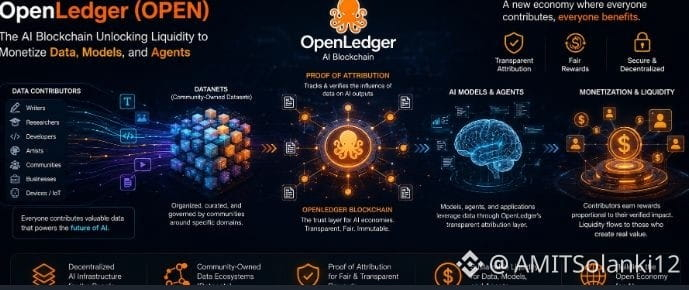
OpenLedger هو أحد تلك المشاريع بالنسبة لي.
لا أقول إنه يعمل. لا أقول إنه يربح. لا أقول حتى إن النموذج مستدام. بصراحة، لا أعرف بعد.
لكنني ألاحظ أن السؤال الأساسي الذي يطرحه يبدو أكثر واقعية من معظم الروايات المتعلقة بالذكاء الاصطناعي المتداولة في عالم العملات الرقمية الآن.
السؤال بسيط: إذا كانت نماذج الذكاء الاصطناعي أصبحت من بين الأنظمة الأكثر قيمة في العالم، فلماذا لا يعرف تقريبًا أحد من أين تأتي القيمة بالفعل؟
قد يبدو ذلك واضحًا في البداية، لكن كلما فكرت في الأمر أعمق، بدأ الاقتصاد الكلي للذكاء الاصطناعي يبدو أكثر غرابة.
معظم أنظمة الذكاء الاصطناعي اليوم مبنية على محيطات من البيانات التي تم جمعها من أشخاص لا يرون عادة تعويضًا أو ملكية أو حتى اعترافًا. الكتاب، الفنانين، الباحثين، مستخدمي المنتديات، المطورين، المجتمعات المتخصصة، الأرشيفات العشوائية على الإنترنت - كل ذلك يتم امتصاصه في نماذج تصبح في النهاية منتجات تساوي مليارات.
وبطريقة ما، قبل الجميع ذلك على أنه طبيعي.
ربما لأن الأنظمة أصبحت كبيرة جدًا بحيث لا يمكن التساؤل عنها. ربما لأن