
انظر حولك في فضاء Web3، وستلاحظ نمطاً متكرراً وم exhausting تقريباً: الكريبتو يحب أن يعامل المشاكل السلوكية البشرية كمهام هندسية بسيطة.
يظهر مشروع جديد، ويطرح ورقة بيضاء ثقيلة مليئة بالمصطلحات المعمارية، وفجأة يتصرف الجميع كما لو أن الكود النظيف يمكن أن يصلح الحوافز البشرية المعطلة. لم يحدث ذلك من قبل، ولن يحدث.
الحقيقة القبيحة والواقعية للاقتصادات الرقمية أبسط بكثير، لكنها أصعب بكثير في الحل: الناس يخلقون القيمة باستمرار، لكن الأنظمة تفشل باستمرار في تتبع من يستحق فعلاً الفضل.
أحكم Web2 السيطرة على هذه العلاقة الاستنزافية. أنتج المستخدمون البيانات، وضبطوا الخوارزميات عبر نقراتهم، وبنوا المشهد الرقمي. استحوذت المنصات على 99% من المكاسب المالية. والآن يدخل الذكاء الاصطناعي إلى الغرفة، وهو يجعل أزمة التقاط القيمة أكثر تعقيداً بلا حدود.
لأن الذكاء الاصطناعي لا يستهلك البيانات فقط. الذكاء الاصطناعي يستهلك مساهمة الإنسان.
الصندوق الأسود لذكاء الآلة
عندما تنظر إلى مخرجات ذكاء اصطناعي—سطر كود، أو قطعة فن رقمية، أو استراتيجية تداول—فأنت ترى منتجاً نهائياً مُصقولاً. ما لا تراه هو الآلية الفوضوية والمجزأة تحت السطح.
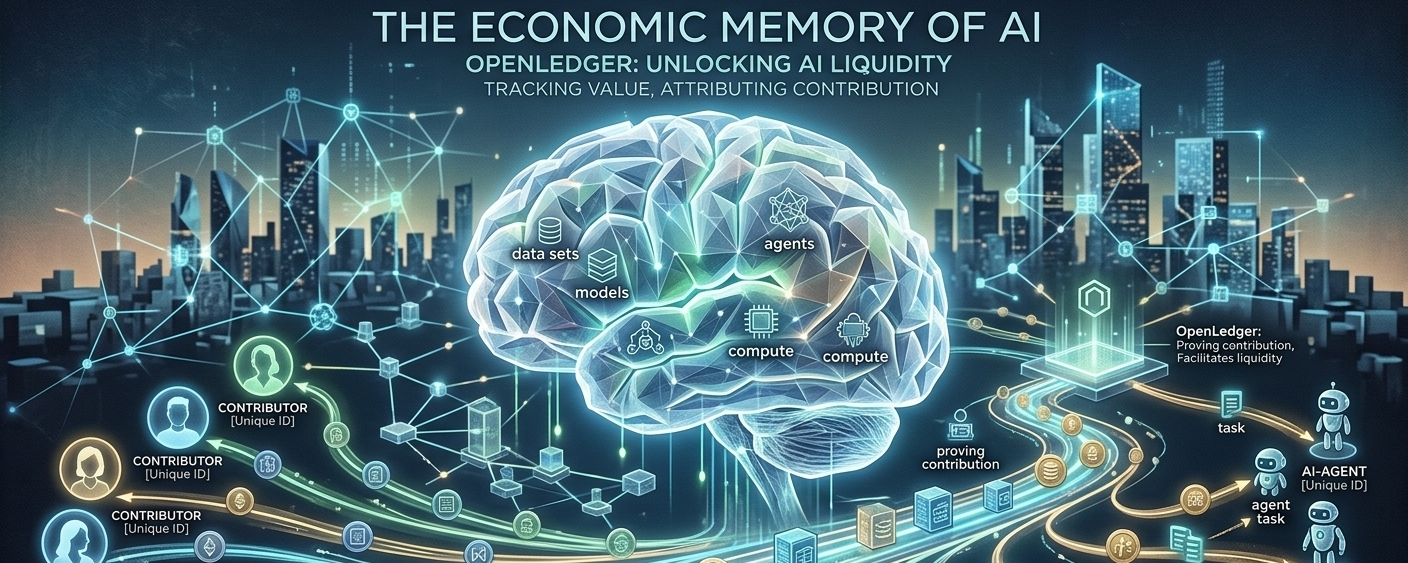
مخرجات الذكاء الاصطناعي تصادم بين عوالم منفصلة:
حقن البيانات: مجموعات ضخمة تم انتقاؤها عبر آلاف الأيدي الفردية.
معمارية النموذج: شبكات عصبية صُممت بواسطة باحثين.
بنية تحتية للحوسبة: معالجة بيانات بأجهزة ثقيلة على نطاق هائل.
العملاء/الكيانات المستقلة: كيانات متخصصة تنفذ مهاماً صغيرة.
في التصنيع التقليدي، لدينا سلاسل توريد. يعرف مُصنّع السيارات بالضبط مصدر كل برغي، وقطعة جلد، ورقاقات مايكرو. وتكون ملكية الموارد ذات حدود قانونية واضحة.
إن الذكاء الاصطناعي يشوّه تماماً تلك الحدود. يأخذ البيانات من المصدر (A)، ونموذج من المُنشئ (B)، وحوسبة من المُزوّد (C)، ويُخرج تجربة مستخدم مثالية حيث تُصبح جميع المساهمات الأصلية غير مرئية.
هذه ليست مشكلة أخلاقية فقط؛ إنها عنق زجاجة اقتصادي هائل. تتوقف الاقتصادات عن العمل عندما يدرك المشاركون أن مدخلاتهم لا تُفضي إلى مكافآت قابلة للتتبّع.
هيا ندخل OpenLedger: بناء طبقة تنسيق، لا مجرد سردية
هذه هي الجِرح بالضبط الذي تحاول OpenLedger ترميمه. فهم لا يطلقون سردية ذكاء اصطناعي فارغة أخرى، ولا يحاولون ضخ قصة توكن مؤقتة. إنهم يطرحون سؤالاً أكثر مللاً—ومع ذلك خطيراً تماماً:
كيف تُنشئ ذاكرة اقتصادية حول الذكاء نفسه؟
امزق ضجيج المصطلحات المشفّرة، وفكرة OpenLedger الأساسية واضحة وبسيطة: تعمل أنظمة الذكاء الاصطناعي على مدخلات. تأتي هذه المدخلات من مساهمين حقيقيين. لذلك يجب أن تترك تلك المساهمات بصمة دائمة وقابلة للقياس داخل دورة الحياة الاقتصادية لذلك الذكاء الاصطناعي.
بدلاً من أن تختفي مجموعات البيانات والنماذج والكيانات داخل الصندوق الأسود للشركات، تضع OpenLedger نفسها كطبقة تنسيق لامركزية. فهي لا تتعامل مع هذه العناصر كأدوات معزولة، بل كجهات اقتصادية نشطة ومرئية.
تخيلها مثل الخدمات اللوجستية قبل سلاسل التوريد الحديثة. كانت المصانع والسفن والمواد الخام موجودة دائماً، لكن التنسيق كان مكسوراً. تسربت القيمة في كل مكان بسبب نقص الرؤية. لا تحاول OpenLedger اختراع ذكاء ذكاء اصطناعي؛ بل تسعى إلى تنظيمه.
فخ التوكِنوميكس: التمييز بين الحركة والزخم
لكن لنكن صريحين تماماً. التنفيذ في هذا المجال حقل ألغام، وتواجه OpenLedger التهديد الوجودي نفسه الذي دمر عشرات النظم البيئية الواعدة ضمن Web3: تحويل الحوافز إلى لعبة.
للعملات المشفّرة عادة سيئة تتمثل في الوقوع في حب المقاييس السطحية. نتفحص لوحات Dune، وننظر إلى حجم المعاملات، وعدد المحافظ النشطة، والتفاعل الاجتماعي الصاخب، ونقنع أنفسنا بأن المشروع ينجح.
لقد شاهدنا هذا الفيلم من قبل. رأيناه مع تعدين سيولة DeFi. ورأيناه مع الألعاب Play-to-Earn (P2E). بدت النظم البيئية ضخمة تماماً إلى أن جفّت المكافآت—ثم اختفى المستخدمون بين ليلة وضحاها. لقد خلطوا بين الزراعة والطلب الحقيقي في السوق.
من اللحظة التي تجعل فيها البيانات ومساهمة الذكاء الاصطناعي قابلة للقياس، يتغيّر عقل المستخدمين. يتوقفون عن السؤال «كيف أساهم بشيء مفيد حقاً؟» ويبدأون السؤال «كيف ألعب على خوارزمية لتحقيق أقصى قدر من $OPEN مكافآتي؟»
على دفتر الأستاذ (بلوك تشين)، يمكن لحقل مزرعة بوتات سيبِل أن يبدو متشابهًا بشكل مقلق مع مساهم بيانات بشرية عالية الجودة. قد تتنكر الحجوم المزيفة كصحة للشبكة، بينما تُدفن المنفعة العضوية الحقيقية تحت الضوضاء.
الأسئلة غير المتسامحة التي يجب على OpenLedger الإجابة عنها
نادراً ما تفوز التكنولوجيا المتفوقة في السوق. بل تفوز الراحة والسرعة والبساطة. إذا أرادت OpenLedger أن تبقى بعد مرحلة الحوافز الأولية، فعليها الإجابة عن الأسئلة غير الجذابة التي تتجاهلها أغلب المشاريع المهووسة بالضجيج:
الجودة مقابل الضوضاء: كيف يفلتر البروتوكول البيانات التركيبية والقمامة المصممة حصراً لحصاد المكافآت؟
الإسناد التفصيلي: عندما يستخدم نموذج ذكاء اصطناعي 50,000 مدخل بيانات مختلف لإنتاج مخرج واحد ذا قيمة، كيف تقسم المكافآت الدقيقة بعدالة؟
الخصوصية مقابل المَنشأ: كيف تتعقّب سلسلة نسب البيانات ونسبتها دون المساس بخصوصية المستخدمين أو كشف بيانات مُلكية؟
تدفق قيمة خارجي: كيف يجلب النظام البيئي إيراداً مستداماً من الخارج حتى لا تكون القيمة مجرد دوران في حلقة مغلقة وتخمينات؟
الخلاصة: سيكون النسيان مكلفاً
ليست OpenLedger ضماناً لصفقة رابحة، لكنها أيضاً ليست آلة ضجيج فارغة. إنها تقع في منطقة وسطية حاسمة. إنها تراهن رهناً اقتصادياً طويل الأجل بأن الذكاء ذاته سيصبح—خلال العقد القادم—فئة أصول سائلة وقابلة للتداول.
إذا كانت هذه الرهان صحيحاً، فإن الطريقة التقليدية للتعامل مع بيانات الذكاء الاصطناعي غير قابلة للاستمرار تماماً. لا يمكننا بناء مستقبل ذكاء عالمي على أساس مساهمات بشرية غير مُعتمدة وغير مُتتبّعة.
في النهاية، قد لا تكون نجاحات OpenLedger هي القصة الرئيسية هنا أصلاً. العبرة الحقيقية هي أن اقتصاديات الذكاء الاصطناعي المستقبلية ستتطلب حتماً نظاماً يتذكر من بنَاها. لأن الذكاء عندما يصبح المحرك الأساسي للثروة العالمية، سيصبح نسيان من ساهم في بنائها باهظ التكلفة ببساطة.