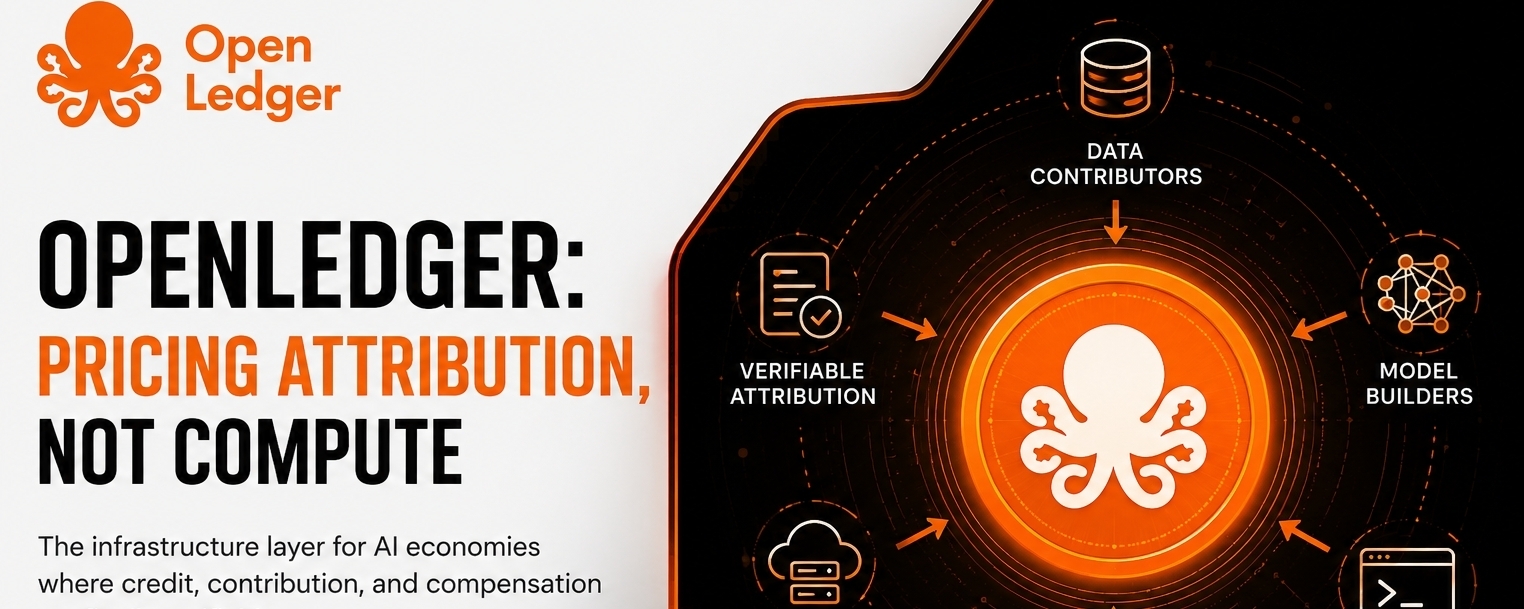
OpenLedger هو أحد المشاريع الناشئة التي تحاول الجمع بين اثنتين من أسرع الصناعات نمواً في العالم اليوم: الذكاء الاصطناعي وتقنية البلوك تشين. بينما تستخدم العديد من مشاريع العملات المشفرة كلمة “AI” لأغراض التسويق فقط، يحاول OpenLedger بناء شيء أعمق وأكثر عملية. يتمثل هدفه في إنشاء نظام بيئي لا مركزي يمكن فيه أن تصبح البيانات ونماذج الذكاء الاصطناعي وعملاء الذكاء الاصطناعي أصولاً رقمية قيّمة يمكن للناس امتلاكها واستخدامها والتداول بها وتحويلها إلى دخل بشكل علني.
لفهم سبب أهمية OpenLedger، من الضروري أولاً فهم كيفية عمل صناعة الذكاء الاصطناعي الحالية. يتم التحكم في معظم أنظمة الذكاء الاصطناعي الحديثة بواسطة شركات مركزية كبيرة. تجمع هذه الشركات كميات هائلة من البيانات من المستخدمين، وتقوم بتدريب نماذج ذكاء اصطناعي قوية بشكل خاص، وتحافظ على معظم الأرباح والتحكم ضمن نظمها البيئية الخاصة. غالباً ما يساهم المستخدمون العاديون والمطورون والمساهمون في بناء هذه الأنظمة بشكل غير مباشر، لكنهم نادراً ما يحصلون على مكافآت عادلة مقابل مساهماتهم.
هذه هي المشكلة التي يحاول OpenLedger حلّها.
يريد المشروع بناء نظام تُقدَّم فيه مكافآت للمساهمين بشكل عادل مقابل القيمة التي يضيفونها إلى اقتصاد الذكاء الاصطناعي. بدلًا من أن تُقفل البيانات داخل خوادم مركزية، يريد OpenLedger أن تصبح البيانات أصلًا رقميًا سائلًا يمكنه توليد قيمة بشفافية. بدلًا من بقاء نماذج الذكاء الاصطناعي ملكية خاصة لعدد قليل من الشركات، قد يتمكن المطوّرون من تحقيق الدخل من نماذجهم داخل منظومة مفتوحة. وبدلًا من أن تعمل وكلاء الذكاء الاصطناعي فقط داخل منصات مغلقة، يمكن للوكلاء المستقلين التفاعل اقتصاديًا على السلسلة عبر بنية تحتية لامركزية.
قد تبدو هذه الفكرة معقّدة في البداية، لكن يصبح المفهوم أسهل عندما يتم تفكيكه إلى أجزاء بسيطة.
يعتقد OpenLedger أن البيانات أصبحت واحدة من أكثر الموارد قيمة في العالم الحديث. لا يمكن لأنظمة الذكاء الاصطناعي أن تعمل دون كميات هائلة من المعلومات. يعتمد كل روبوت محادثة (chatbot) أو نظام توصيات أو خوارزمية تداول أو أداة أتمتة على البيانات لتتعلم الأنماط وتحسن الأداء. ومع ذلك، فإن الأشخاص الذين يساهمون بهذه البيانات غالبًا ما يحصلون على قيمة قليلة جدًا أو لا يحصلون على قيمة مباشرة منها. يريد OpenLedger تغيير ذلك عبر إنشاء بنية تحتية تصبح فيها مجموعات البيانات أصولًا قابلة لتحقيق الدخل.
على سبيل المثال، تخيّل أن شركة أو شخصًا يمتلك بيانات قيّمة متعلقة بالتمويل أو الرعاية الصحية أو سلوك العملاء أو اتجاهات السوق. في النظام التقليدي، قد تبقى هذه البيانات مخزّنة بشكل خاص أو تُباع عبر اتفاقيات مركزية. يريد OpenLedger إنشاء بيئة قائمة على تقنية البلوك تشين يمكن من خلالها تتبّع ملكية البيانات وسجلّ المساهمات وحقوق الوصول بشفافية. إذا استُخدمت البيانات لتدريب نماذج الذكاء الاصطناعي أو لتشغيل تطبيقات ذكاء اصطناعي، فقد يحصل المساهمون على مكافآت عبر المنظومة البيئية.
هنا تصبح مصطلحات مثل “تحرير السيولة” (unlocking liquidity) مهمة.
تعني السيولة في الأساس جعل شيء ما نشطًا اقتصاديًا وقابلًا للاستخدام. إن مجموعة بيانات موجودة بشكل خاص على قرص صلب يكون نشاطها الاقتصادي محدودًا. لكن إذا أمكن التحقق من هذه المجموعة والوصول إليها بشكل آمن وتحقيق الدخل منها وترخيصها ودمجها في أنظمة الذكاء الاصطناعي، فإنها تكتسب سيولة. يريد OpenLedger أن يفعل الشيء نفسه ليس فقط للبيانات، بل أيضًا لنماذج الذكاء الاصطناعي ووكلاء الذكاء الاصطناعي.
يركز المشروع أيضًا بقوة على نماذج الذكاء الاصطناعي نفسها. يقضي المطوّرون كميات كبيرة من الوقت والموارد في إنشاء أنظمة ذكاء اصطناعي مفيدة، لكن فرص تحقيق الدخل غالبًا ما تكون محدودة ما لم يعملوا مع شركات كبرى. يهدف OpenLedger إلى توفير بنية تحتية لامركزية يمكن للمطوّرين من خلالها نشر نماذجهم وإدارتها وربما تحقيق الدخل منها مباشرة داخل المنظومة. قد يفتح ذلك فرصًا للمطوّرين المستقلين الذين يريدون المشاركة في اقتصاد الذكاء الاصطناعي المتنامي دون الاعتماد بالكامل على منصات مركزية.
من المجالات الكبرى الأخرى التي يستكشفها OpenLedger وكلاء الذكاء الاصطناعي. وكلاء الذكاء الاصطناعي هم أنظمة برمجية مستقلة قادرة على تنفيذ المهام تلقائيًا. قد تشمل هذه المهام البحث أو التداول أو التحليلات أو دعم العملاء أو الأتمتة أو توليد المحتوى أو وظائف ذكية أخرى. يتجه مستقبل الذكاء الاصطناعي بشكل متزايد نحو أنظمة قائمة على الوكلاء حيث تتفاعل أدوات الذكاء الاصطناعي بشكل مستقل مع البيئات الرقمية.
يريد OpenLedger لهذه وكلاء الذكاء الاصطناعي أن تعمل اقتصاديًا داخل بنية تحتية لامركزية. في المستقبل، قد تدفع الوكلاء مقابل الوصول إلى البيانات، أو تشترى موارد حوسبية، أو تقدم خدمات، أو تكسب مكافآت، أو تتفاعل مع وكلاء آخرين بشكل مستقل. يخلق ذلك إمكانية نوع جديد بالكامل من الاقتصاد الرقمي حيث تشارك الأنظمة الذكية مباشرةً في النشاط الاقتصادي.
تؤدي تقنية البلوك تشين دورًا بالغ الأهمية في كل ما سبق. يستخدم OpenLedger البلوك تشين لأنه يوفر الشفافية وتتبع الملكية واللامركزية وحوافز قابلة للبرمجة. يمكن تسجيل كل مساهمة داخل المنظومة البيئية والتحقق منها على السلسلة (on-chain) بشكل محتمل. وهذا يخلق الثقة بين المشاركين دون الاعتماد بالكامل على وسطاء مركزيين.
الرمز الأصلي للمنظومة يُسمّى OPEN. مثل كثير من مشاريع البلوك تشين، يعمل الرمز كطبقة اقتصادية للشبكة. قد يُستخدم في الحوكمة والحوافز ورسوم المعاملات والوصول إلى الخدمات والتخزين (staking) والمشاركة في المنظومة البيئية وتوزيع المكافآت. ومع نمو المنظومة، قد تتوسع دورية وفعالية الرمز بشكل أكبر.
سبب واحد من الأسباب التي تجعل الكثير من الناس يهتمون بـ OpenLedger هو أنه يركز على البنية التحتية وليس على الضجة قصيرة المدى. تحاول العديد من مشاريع العملات المشفرة خلق حالة من الحماس عبر المضاربة وحدها، لكن مشاريع البنية التحتية تهدف إلى بناء أنظمة أساسية يمكن للتطبيقات الأخرى استخدامها في النهاية. يضع OpenLedger نفسه كونه بنية تحتية لاقتصادات ذكاء اصطناعي لامركزية.
توقيت هذه الفكرة مهم أيضًا. يُصبح الذكاء الاصطناعي حاليًا واحدًا من أكبر الثورات التكنولوجية في العالم. تتسابق الحكومات والشركات والناشئون والمستثمرون لبناء أنظمة ذكاء اصطناعي. وفي الوقت نفسه، تتزايد بسرعة المخاوف بشأن المركزية والملكية والخصوصية والسيطرة. يقع OpenLedger مباشرةً في قلب هذه النقاشات.
إن المشروع في جوهره يطرح سؤالًا مهمًا جدًا:
من ينبغي أن يمتلك اقتصاد الذكاء الاصطناعي في المستقبل؟
هل ينبغي أن يظلّ الذكاء الاصطناعي تحت سيطرة عدد صغير من الشركات، أم يجب أن يشارك المساهمون والمطوّرون والمجتمعات أيضًا في عملية خلق القيمة؟
يحاول OpenLedger إنشاء نموذج بديل يمكن من خلاله أن يتدفق رصيد/قيمة الذكاء الاصطناعي بشكل أكثر انفتاحًا عبر منظومة لا مركزية.
بالطبع، يواجه المشروع أيضًا تحديات كبيرة. يعد بناء بنية تحتية لذكاء اصطناعي لامركزية أمرًا شديد الصعوبة من الناحيتين التقنية والاقتصادية. تتحرك صناعة الذكاء الاصطناعي بسرعة كبيرة، وتزداد المنافسة بسرعة، ويحاول العديد من المشاريع دمج الذكاء الاصطناعي مع تقنية البلوك تشين. سيكون التبنّي أيضًا واحدًا من أكبر الاختبارات. يجب أن يجذب OpenLedger المطورين والشركات والمستخدمين والمساهمين لبناء تأثيرات شبكية قوية. وبدون مشاركة فعّالة من المنظومة البيئية، قد تواجه حتى التكنولوجيا القوية صعوبة في النمو.
قد تصبح أيضًا عملية التنظيم عاملًا مهمًا في المستقبل. بدأت الحكومات حول العالم في إيلاء اهتمام أكبر لكلٍّ من أنظمة الذكاء الاصطناعي وتقنيات البلوك تشين. قد تؤثر القوانين المستقبلية المتعلقة بملكية البيانات والحوكمة الخاصة بالذكاء الاصطناعي والخصوصية والأنظمة اللامركزية على كيفية تطور مشاريع مثل OpenLedger مع مرور الوقت.
على الرغم من هذه التحديات، يبقى تصور OpenLedger قويًا لأنه يتوافق مع اتجاهات تكنولوجية أكبر كانت بالفعل تشكّل العالم. يصبح الذكاء الاصطناعي أكثر قيمة كل عام. تصبح البيانات أكثر أهمية كل عام. تتوسع الأتمتة بسرعة. تستمر اللامركزية في تحدي البنى التقليدية للإنترنت. يحاول OpenLedger دمج كل هذه الاتجاهات في منظومة واحدة.
يمثل المشروع أكثر من مجرد رمز عملة مشفرة أخرى. إنه يمثل محاولة لبناء بنية تحتية اقتصادية لجيلٍ قادم من أنظمة الذكاء الاصطناعي. بدلًا من التعامل مع الذكاء الاصطناعي باعتباره شيئًا يتحكم فيه كبار الشركات فقط، يتصور OpenLedger مستقبلًا تصبح فيه أصول الذكاء الاصطناعي مفتوحة وقابلة للبرمجة وممكنة اقتصاديًا.
من نواحٍ كثيرة، يعكس المشروع التطور الأوسع للإنترنت نفسه. ركّزت الإصدارات المبكرة من الإنترنت بشكل أساسي على مشاركة المعلومات والتفاعل الاجتماعي. أدخلت البلوك تشين فكرة الملكية الرقمية ونقل القيمة بشكل لامركزي. والآن يُدخل الذكاء الاصطناعي قدرات ذكاء آلي إلى العالم الرقمي. يحاول OpenLedger ربط كل هذه الطبقات معًا في اقتصاد موحّد واحد.
ما إذا كان OpenLedger سيصبح لاعبًا رئيسيًا في مجال البلوك تشين للذكاء الاصطناعي في النهاية سيعتمد على التنفيذ وتبنّي الحلول والتقنية والشراكات ونمو المنظومة البيئية على المدى الطويل. لكن الفكرة الأساسية خلف المشروع تجذب الانتباه بالفعل لأنها تتناول واحدًا من أهم الموضوعات في العصر الرقمي الحديث: كيف ينبغي توزيع الذكاء والبيانات والقيمة في اقتصاد المستقبل.
لهذا السبب تتم مراقبة OpenLedger عن كثب من قبل المطورين والمستثمرين والأشخاص المهتمين بالتقاطع المستقبلي بين الذكاء الاصطناعي والبلوك تشين.