نحلّل أطروحة استثمار قطاع الذكاء الاصطناعي + Web3 اليوم. ليست المشكلة الأكبر للذكاء الاصطناعي في الوقت الحالي نقصًا في القدرة الحاسوبية بعد، بل أزمة بيانات عالية الجودة ومتطلبات قانونية تتعلق بحقوق الطبع والنشر الخاصة بمجموعة البيانات.
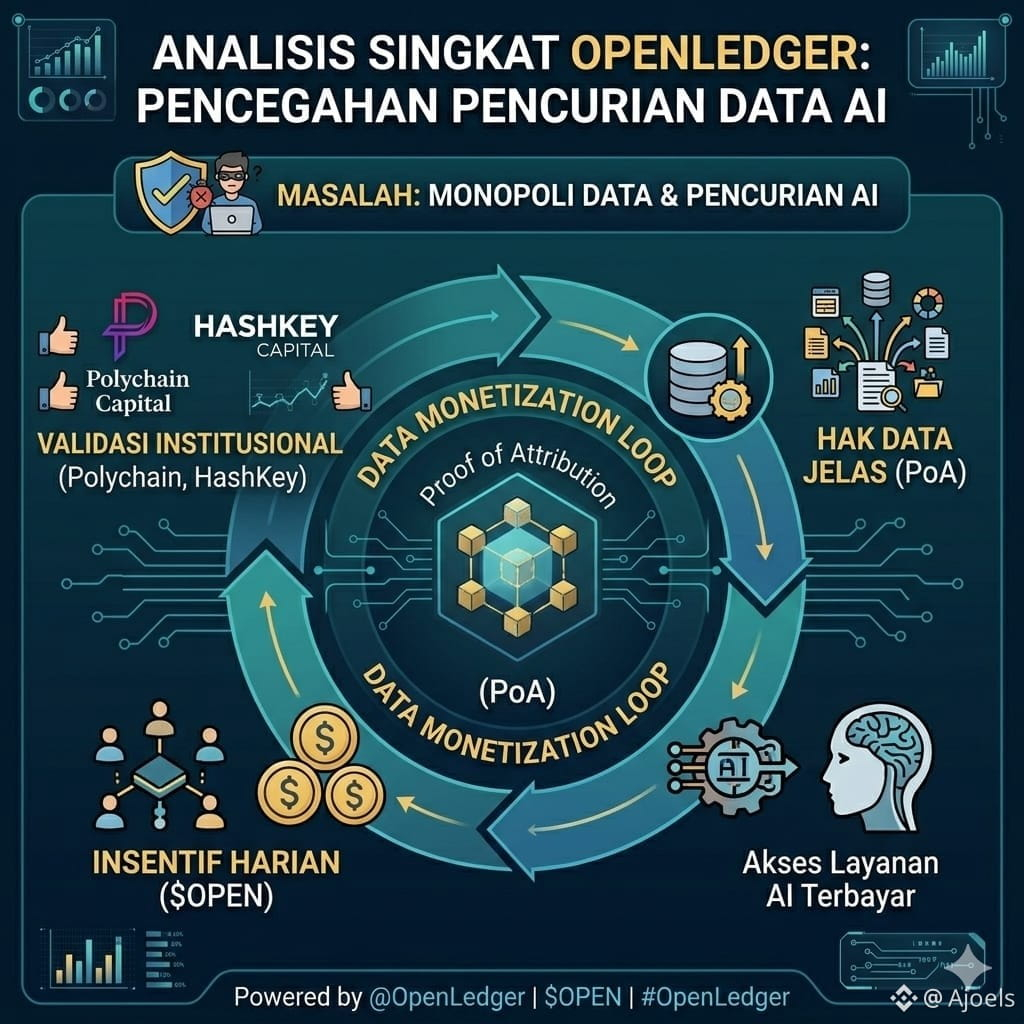
تجذب مشاريع مثل @OpenLedger الانتباه لأنها لا تُكرّر وظائف الحوسبة، بل تركز على طبقة تنفيذ بيانات. ومن خلال تقنية Proof of Attribution، يبتكرون نظام تتبّع قائم على التشفير حتى يتمكن مزوّدو البيانات من الحصول على إتاوات عادلة بشكل مباشر على السلسلة (on-chain).
القيمة الأساسية لرمز $OPEN هنا طبيعية جدًا،
حيث يعمل كأداة الدفع الرئيسية لاستهلاك البيانات، وتكاليف تدريب الذكاء الاصطناعي، ورسوم غاز الشبكة. وبدعم التمويل من Polychain وHashKey، يمتلك هذا المشروع قاعدة قوية لقيادة بنية تحتية لا مركزية لبيانات الذكاء الاصطناعي. كيف ترى إمكانات استدامة نموذج الإسناد (attribution) مثل هذا؟
#openledger $OPEN
تجذب مشاريع مثل @OpenLedger الانتباه لأنها لا تُكرّر وظائف الحوسبة، بل تركز على طبقة تنفيذ بيانات. ومن خلال تقنية Proof of Attribution، يبتكرون نظام تتبّع قائم على التشفير حتى يتمكن مزوّدو البيانات من الحصول على إتاوات عادلة بشكل مباشر على السلسلة (on-chain).
القيمة الأساسية لرمز $OPEN هنا طبيعية جدًا،
حيث يعمل كأداة الدفع الرئيسية لاستهلاك البيانات، وتكاليف تدريب الذكاء الاصطناعي، ورسوم غاز الشبكة. وبدعم التمويل من Polychain وHashKey، يمتلك هذا المشروع قاعدة قوية لقيادة بنية تحتية لا مركزية لبيانات الذكاء الاصطناعي. كيف ترى إمكانات استدامة نموذج الإسناد (attribution) مثل هذا؟
#openledger $OPEN