

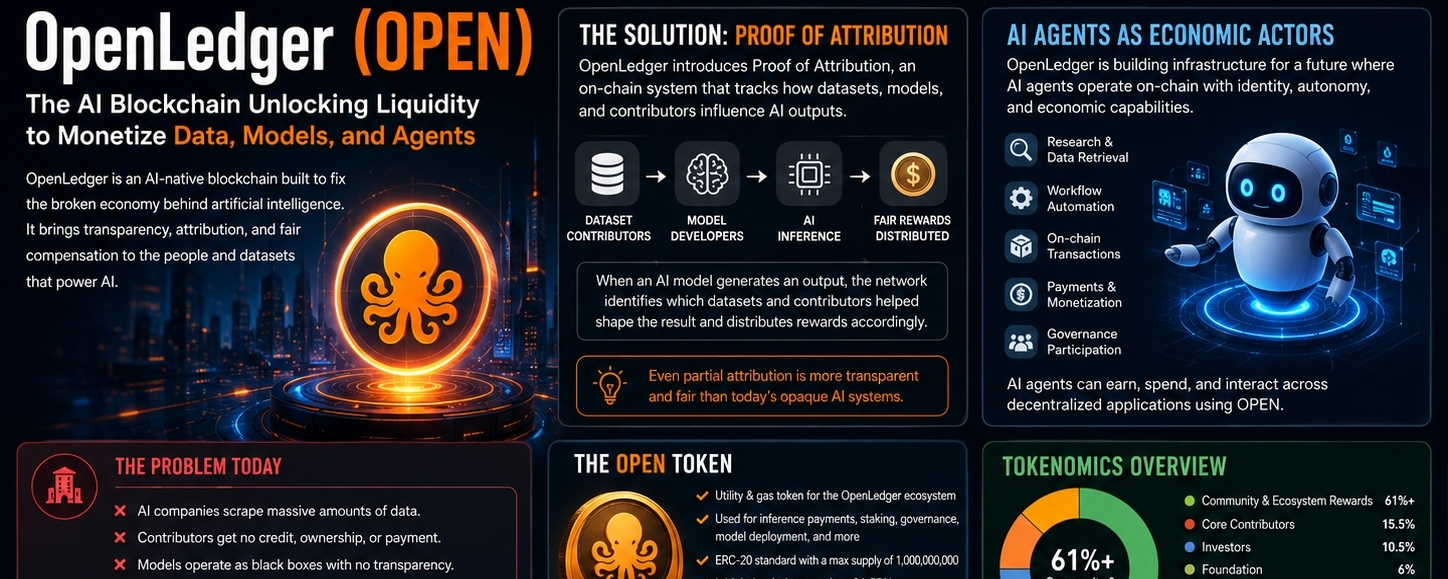
ما يجعل OpenLedger مثيرًا للاهتمام بالنسبة لي ليس فقط لأنه يجمع بين الذكاء الاصطناعي والبلوكشين - فهناك العشرات من المشاريع التي تدعي القيام بذلك. ما يبرز هو المشكلة المحددة التي تحاول حلها: الاقتصاد الخفي وراء الذكاء الاصطناعي. في الوقت الحالي، يتم تدريب معظم أنظمة الذكاء الاصطناعي على كميات هائلة من المحتوى الذي ينشأه البشر، ومع ذلك، نادرًا ما يتلقى الأشخاص الذين ينشئون هذا المحتوى الاعتراف أو الملكية أو الدفع. تم بناء OpenLedger حول فكرة أن هذا الاختلال في التوازن سيصبح في النهاية غير مستدام، وأعتقد أن هذه الملاحظة تصبح أكثر أهمية مع نمو الذكاء الاصطناعي بشكل أسرع من قدرة التنظيم على مواكبته.
في جوهره، يحاول OpenLedger بناء ما يمكنني وصفه بأنه نظام تشغيل مالي لمساهمات الذكاء الاصطناعي. بدل اعتبار البيانات شيئاً تقوم الشركات باختطافه بهدوء وتحويله إلى أرباح إلى الأبد، تحاول الشبكة تحويل مجموعات البيانات والنماذج ووكلاء الذكاء الاصطناعي إلى أصول اقتصادية قابلة للتتبع. قد يبدو ذلك بسيطاً على الورق، لكن إذا نجح على نطاق واسع، فقد يغيّر بشكل جوهري طريقة تدفّق قيمة الذكاء الاصطناعي عبر الإنترنت.
يدور المشروع حول الرمز OPEN وبنية بلوك تشين تحتية مُحسّنة خصيصاً لتطبيقات الذكاء الاصطناعي. بخلاف السلاسل الكتلية التقليدية التي تركز أساساً على المدفوعات أو العقود الذكية، صُمم OpenLedger حول الإسناد. يظهر هذا المصطلح مراراً وتكراراً في وثائق المشروع، وبصراحة أعتقد أنه يشكل الأساس الكامل للنظام البيئي. الإسناد يعني تحديد من ساهم بماذا في نظام ذكاء اصطناعي ومنحهم مكافآت عندما تولّد مساهمتهم قيمة.
في الوقت الحالي، تعمل شركات الذكاء الاصطناعي عادةً كصناديق سوداء. يتم تدريب نموذج على ملايين أو مليارات من المدخلات، وبعد اكتمال التدريب لا يمكن لأحد عملياً تحديد أي مجموعات بيانات أثّرت في أي مخرجات. يعتقد OpenLedger أن هذا النقص في الشفافية يخلق بنية اقتصادية غير عادلة. أظن أنهم على صواب جزئياً. فسباق الذكاء الاصطناعي الحالي يكافئ مالكي البنية التحتية أكثر بكثير من المساهمين، رغم أن المساهمين يوفّرون المادة الخام التي تجعل هذه النماذج ذكية أصلاً.
إجابة OpenLedger المقترحة هي شيء يُسمى Proof of Attribution (إثبات الإسناد). الفكرة هي إنشاء نظام على السلسلة قادر على تتبّع العلاقة بين مجموعات البيانات والنماذج ومخرجات الذكاء الاصطناعي. من الناحية النظرية، عندما ينتج النموذج استدلالاً (inference) أو ينفذ مهمة، يمكن للشبكة تحديد أي مجموعات بيانات ساعدت في تشكيل تلك النتيجة وتوزيع المكافآت وفقاً لذلك. أعتقد أن هذا جزء من أكثر أجزاء المشروع طموحاً، لأن الإسناد داخل الشبكات العصبية يُعد مشكلة تقنية شديدة الصعوبة. نماذج الذكاء الاصطناعي لا تفكر بشكل خطي؛ بل تضغط وتوزع المعرفة عبر مليارات المعاملات (parameters). وهذا يعني أن قياس قيمة المساهمة بدقة أكثر تعقيداً بكثير من تتبع معاملة بلوك تشين عادية.
ومع ذلك، حتى لو حقق OpenLedger إسناداً جزئياً بدلاً من إسناد كامل ودقيق، فقد يُحسن الشفافية مقارنةً بالأنظمة المركزية اليوم. هذه نقطة مهمة برأيي. لا يحتاج المشروع بالضرورة إلى الكمال الرياضي ليصبح مفيداً. كل ما يحتاجه هو إنشاء نظام أكثر مساءلة من الوضع الراهن.
هناك شيء آخر أراه لافتاً وهو كيف يتعامل OpenLedger مع وكلاء الذكاء الاصطناعي. ما زال معظم الناس يفكرون في الذكاء الاصطناعي كأنه روبوتات محادثة أو مساعدون، لكن الصناعة تتجه نحو وكلاء مستقلين قادرين على تنفيذ المهام بشكل مستقل. يمكن لهذه الوكلاء بالفعل البحث عن المعلومات، والتفاعل مع واجهات برمجة التطبيقات (APIs)، وتنفيذ سير العمل (workflows)، وحتى إدارة معاملات البلوك تشين. يبدو أن OpenLedger يتهيأ للبنية التحتية لهذا المستقبل بدلاً من التركيز فقط على اتجاهات الذكاء الاصطناعي الحالية.
في نظام OpenLedger البيئي، تُعامل وكلاء الذكاء الاصطناعي كأنهم فاعلون اقتصاديون تقريباً. يمكنهم التفاعل مع تطبيقات لامركزية، والدفع مقابل الخدمات، وتوليد الإيرادات، والمشاركة في النشاط على السلسلة (on-chain). أعتقد أن هذه الرؤية تتوافق بشكل وثيق مع الاتجاه الذي تسير فيه كلٌّ من الكريبتو والذكاء الاصطناعي. تكنولوجيا البلوك تشين جيدة بطبيعتها في إدارة الملكية والمدفوعات والتحقق، بينما يصبح الذكاء الاصطناعي أكثر استقلالية بشكل متزايد. إن دمج الاثنين يجعل منطقاً استراتيجياً، حتى لو كانت مهمة التنفيذ هائلة.
يلعب الرمز OPEN نفسه عدة أدوار داخل النظام البيئي. فهو يعمل كرمز الغاز (gas) للمعاملات، ومشاركة في الحوكمة، ورهن (staking)، ونشر النماذج، ومدفوعات استدلال الذكاء الاصطناعي. ما لاحظته عند مراجعة وثائق المشروع هو أن نموذج توزيع/اقتصاديات الرموز (tokenomics) يتمحور بشكل كبير حول نمو النظام البيئي، وليس حول الاستخراج الداخلي قصير الأجل. يتم حجز جزء كبير من الإمداد كمكافآت للمجتمع، وحوافز للمساهمين، وبرامج تطوير طويلة الأجل.
هذا لا يضمن تلقائياً الإنصاف، بالطبع. كل مشروع كريبتو يزعم أنه يهتم بمواءمة المجتمع. لكنني أعتقد أن البنية الاقتصادية لـ OpenLedger تعكس الفلسفة الأوسع الكامنة خلف البروتوكول. يكرر الفريق التأكيد على أن الذكاء ينبغي أن يتحول إلى اقتصاد مفتوح وليس احتكاراً مركزياً. سواء تمكنوا فعلاً من تحقيق هذه الرؤية فهذا سؤال آخر، لكن الاتساق الأيديولوجي واضح.
من الناحية التقنية، بُني OpenLedger باستخدام بنية rollup قائمة على Optimism، ما يمنحه مزايا في قابلية التوسع مقارنةً بشبكات Layer 1 الأبطأ. هذا الاختيار منطقي برأيي، لأن العمليات المرتبطة بالذكاء الاصطناعي تولّد كميات كبيرة من النشاط والبيانات. إذا أراد البروتوكول دعم أسواق الاستدلال (inference markets)، وأنظمة الإسناد، وتفاعلات الوكلاء، والتحقق من مجموعات البيانات في آنٍ واحد، فإنه يحتاج إلى بنية تحتية قادرة على التعامل مع إنتاجية (throughput) كبيرة.
أقوى جوانب OpenLedger، برأيي، هو التوقيت. يدخل المشروع السوق خلال فترة تتزايد فيها بسرعة حالات عدم الثقة بالذكاء الاصطناعي المركزي. تناقش الحكومات تنظيم الذكاء الاصطناعي، ويقاضي المبدعون شركات الذكاء الاصطناعي بسبب بيانات التدريب، ويصبح المستخدمون أكثر وعياً بكيفية تسويق/تحويل معلوماتهم إلى أرباح. يضع OpenLedger نفسه مباشرة داخل هذا النقاش.
أعتقد أيضاً أن المشروع يستفيد من التحول السردي الأوسع الذي يحدث داخل الكريبتو. ففي دورات البلوك تشين السابقة كان التركيز قوياً على التمويل المضاربي والرموز الميمية وبنية التداول التحتية. الآن يتزايد الاهتمام بأنظمة قائمة على المنفعة (utility) مرتبطة بالذكاء الاصطناعي والعمليات الحسابية وملكية البيانات والأتمتة. يتناسب OpenLedger بسلاسة مع هذا التحول لأنه يقدم سرداً أكبر من مجرد المضاربة على الرموز.
في الوقت نفسه، لا أعتقد أنه ينبغي النظر إلى المشروع بوصفه مجرد ضجيج (hype) خالص. توجد مخاطر جدية وأسئلة بدون إجابات. لا يزال الإسناد في الذكاء الاصطناعي تحدياً بحثياً غير محلول. كما أن توسيع البنية التحتية للذكاء الاصطناعي اللامركزية مكلف. منافسة شركات التكنولوجيا التي تبلغ قيمتها تريليونات الدولارات صعبة حتى بالنسبة لرواد أعمال لديهم تمويل جيد، ناهيك عن أنظمة بلوك تشين بيئية. أعتقد أن العديد من مشاريع كريبتو الذكاء الاصطناعي تقلل من تقدير مدى صعوبة الانتقال من الفكرة إلى تبنٍّ ذي معنى.
هناك أيضاً احتمال أن تقوم شركات ذكاء اصطناعي مركزية بدمج أنظمة الإسناد (attribution) في نهاية المطاف بأنفسها، ما يقلل الحاجة إلى بدائل لامركزية. إذا أنشأت شركات مثل OpenAI أو Google أو Anthropic نماذج تعويض شفافة داخلها، فقد تخسر مشاريع مثل OpenLedger جزءاً من تميّزها. ومن ناحية أخرى، قد تظل شبكات البلوك تشين محتفِظة بأفضلية في الحياد والشفافية، لأنها تعمل على بنية تحتية عامة وليس ضمن أنظمة شركات مغلقة.
ما يجعل OpenLedger مقنعاً لي في النهاية هو أنه يحاول معالجة مشكلة بنيوية حقيقية بدل اختراع مشكلة لأغراض التسويق. الخلل بين خلق قيمة الذكاء الاصطناعي وتعويض المساهمين خلل حقيقي. فملايين الأشخاص يوفّرون بيانات من دون أن يدركوا ذلك، وهي ما يقدّم القوة للأنظمة الحديثة للذكاء الاصطناعي، بينما تلتقط نسبة صغيرة جداً من الشركات معظم العوائد الاقتصادية الإيجابية. يجادل OpenLedger عملياً بأن الذكاء ذاته ينبغي أن يصبح فئة أصول سائلة وقابلة للتتبع وقابلة للبرمجة.