العنوان:
OpenLedger يبدو كأنه سلسلة ذكاء اصطناعي… لكن $OPEN قد يكون فعلاً يقيّم نسبة البيانات، وليس الحوسبة 🧠🔍
إذا نظرت عن كثب إلى مشهد الذكاء الاصطناعي اللامركزي (DeAI)، فإن 90% من المشاريع تبدو متطابقة. إنهم يتسابقون لتسعير قوة الحوسبة - بشكل أساسي بناء مزارع خوادم لامركزية لاستئجار وحدات معالجة الرسوميات (GPUs). ولكن OpenLedger ($OPEN) ينفذ بهدوء خطة مختلفة تمامًا.
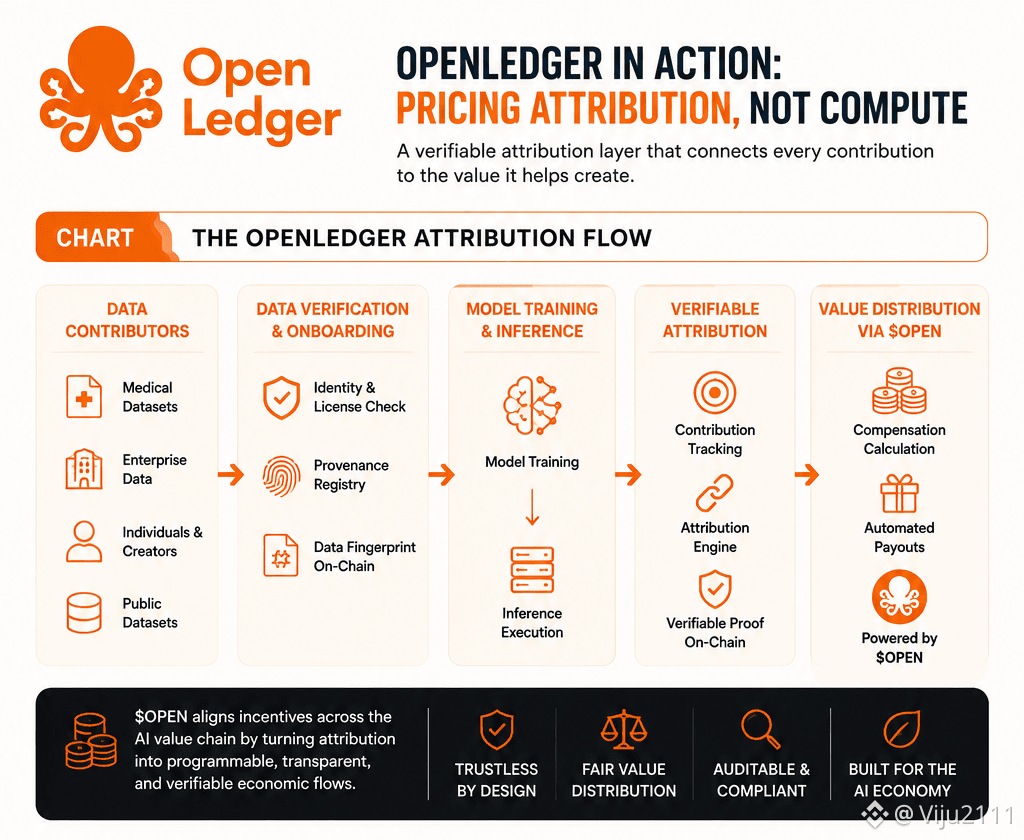
بينما يبدو ويتنفس ويتصرف كسلسلة كتلة عالية الأداء للذكاء الاصطناعي على السطح، فإن محركه الاقتصادي الأساسي لا يقوم بتسعير دورات الحوسبة. إنه يقوم بتسعير نسبة بيانات الذكاء الاصطناعي.
إليك لماذا تعتبر هذه التمييز مهمًا لقيمة $OPEN المستقبلية.
فخ الحوسبة مقابل عنق الزجاجة في البيانات
استئجار وحدات معالجة الرسوميات (حوسبة لامركزية) هو سباق نحو القاع. الشركات التقنية الكبيرة تقوم ببناء مراكز بيانات مركزية ضخمة، وبروتوكولات الحوسبة في الويب 3 تتنافس باستمرار على الأسعار. الحوسبة هي سلعة.
لكن البيانات ليست كذلك. أكبر عنق زجاجة في الذكاء الاصطناعي اليوم ليس العثور على بطاقة رسومات؛ بل هو الحصول على بيانات عالية الجودة، متخصصة، ونظيفة يمكن التحقق منها لتدريب النماذج. بنية OpenLedger - التي بُنيت كهيكل متوافق مع EVM باستخدام OP Stack - تركز تمامًا على هذه البيانات. من خلال ما يسمى Datanets، يمكن للمجتمعات المشاركة في إنشاء، استضافة، وتنظيم مجموعات بيانات متخصصة على السلسلة.
ندخل إلى إثبات النسبة (PoA)
هنا تصبح فيزياء توكن $OPEN مثيرة للاهتمام. بدلاً من استخدام آلية إثبات العمل أو إثبات الحصة القياسية لتأمين المعاملات فقط، تنفذ OpenLedger إثبات النسبة (PoA).
💡 إثبات النسبة هو آلية على مستوى البروتوكول تتعقب بالضبط كيف تؤثر مجموعة بيانات معينة، LoRA، أو نموذج أساسي على ناتج وكيل الذكاء الاصطناعي النهائي.
عندما يتم نشر نموذج ذكاء اصطناعي أو يجيب وكيل الذكاء الاصطناعي على استفسار، تتتبع OpenLedger سلالة البيانات المستخدمة مرة أخرى على السلسلة. إذا كانت بياناتك المساهمة قد ساعدت في تحسين ذلك النموذج، يتحقق البروتوكول من ذلك ويضمن لك الحصول على الاعتماد. @OpenLedger #OpenLedger