

ما انتبهت له في البداية. OpenLedger كان يبدو كأنه مشروع AI آخر لف نفسه بوعود أنظف وأوضح.
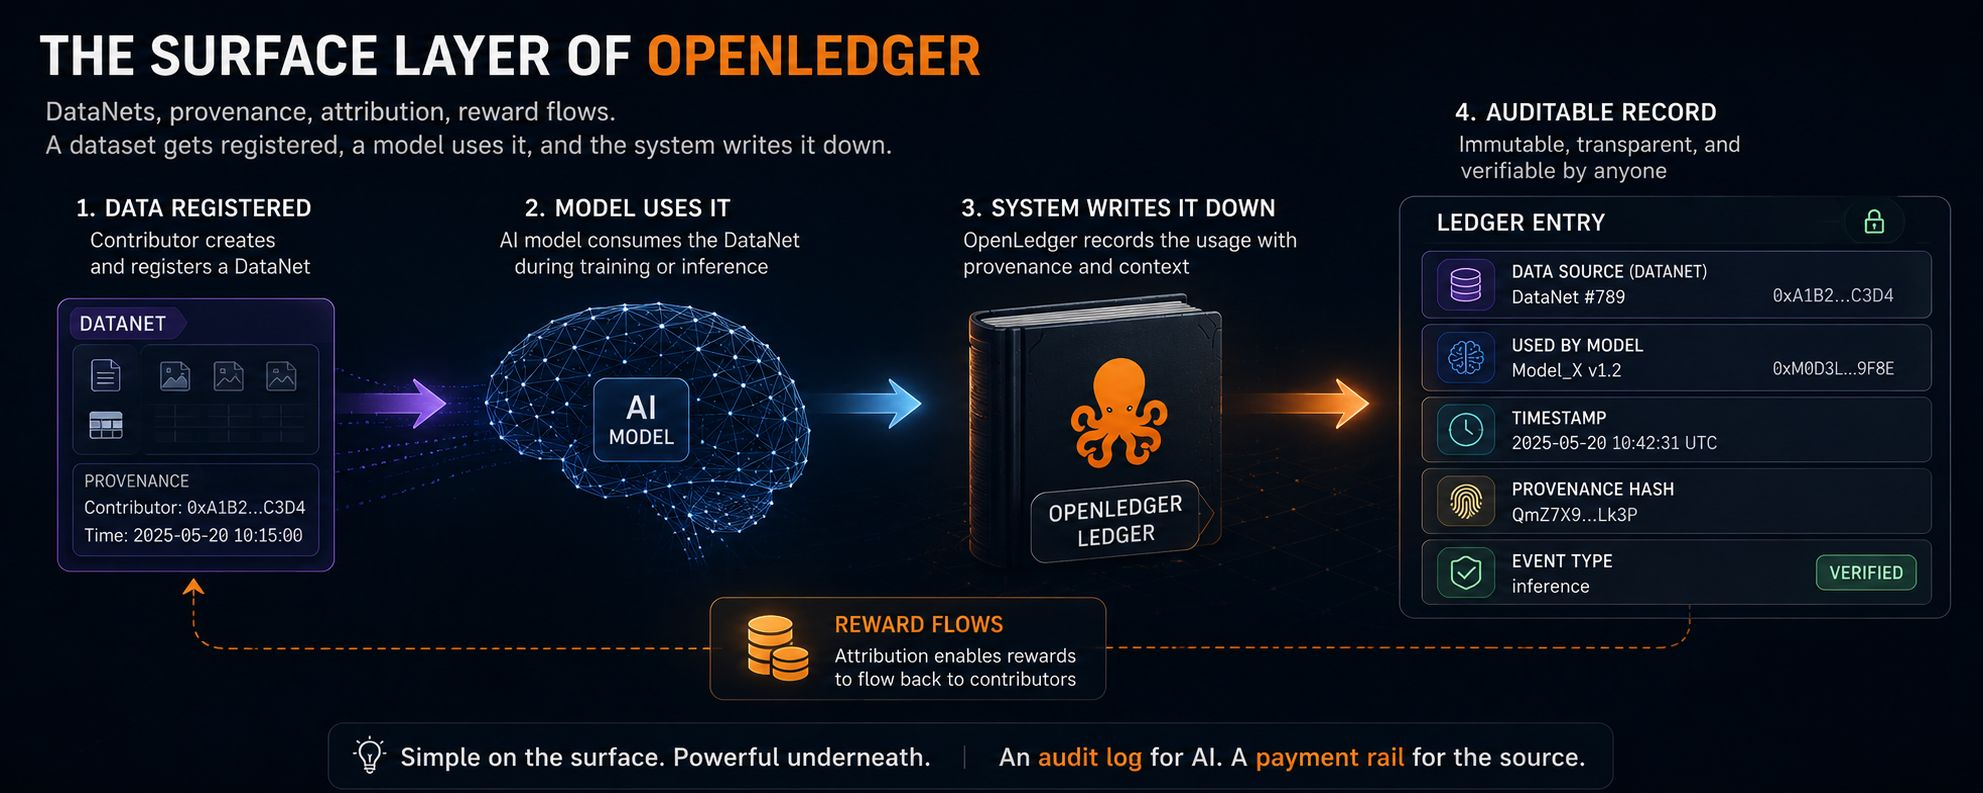
أول شيء شفته كان طبقة السطح. بيانات الشبكات، المصدر، النسبة، تدفقات المكافآت. كل هالكلام كان يبدو مرتب كفاية، تقريباً مألوف إذا كنت تابعت مشاريع البنية التحتية تحاول تخلي التعلم الآلي واضح.
الشيء اللي بقى في ذهني كان كيف كان عادي في البداية. مجموعة بيانات تتسجل، نموذج يستخدمها، والنظام يسجلها. مافي شيء دراماتيكي. بس دفتر أستاذ باسم أكثر طموحاً من معظم.
بعد ذلك، راقبتُ مساهمين اثنين يبنيان DataNets تبدو متشابهة بما يكفي لتكون قابلة للتبديل. النوع نفسه من البنية. الجهد نفسه. ومع ذلك، استمرت واحدة في الظهور ضمن آثارٍ لاحقة بينما بالكاد تحركت الأخرى.
كانت تلك هي النقطة التي بدأ عندها الاحتكاك. بدا الأمر غير متساوٍ قليلاً بطريقة لا علاقة لها بجودةٍ ظاهرة في الواجهة الأمامية. لم تكن الفروق متعلقة بمن نشر أكثر أو بمن وصل أبكر. كان الأمر حول أي بيانات تصبح مفيدة لاحقاً، وما إذا كان النظام يستطيع فعلاً أن يرى تلك الفائدة عندما يجيب النموذج شخصاً آخر.
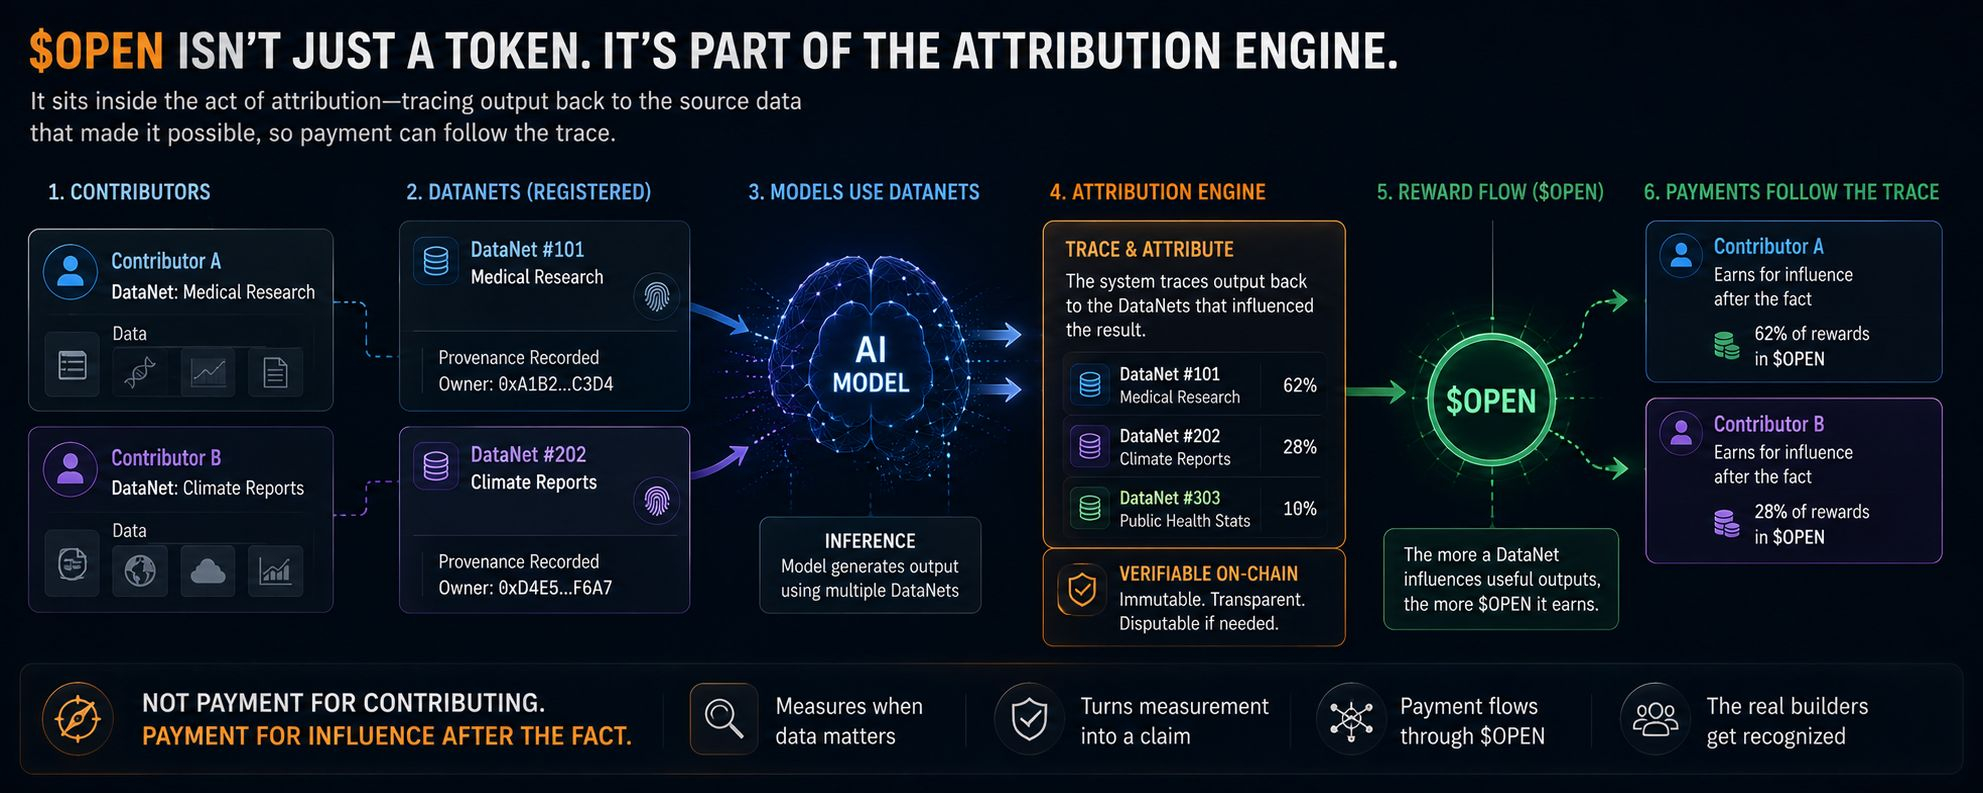
لم أقتنع تماماً بعد، لكن هذه هي النقطة التي بدأت فيها OPEN تبدو مختلفة بالنسبة لي. لا يبدو أنها تجلس فوق طبقة الذكاء الاصطناعي كمجرد رمزٍ زخرفي. بل تجلس داخل فعل الإسناد ذاته، حيث يُعاد تتبع المخرجات إلى البيانات التي جعلتها ممكنة ويمكن أن تتبع الدفعة ذلك التتبع.
هذا يغيّر مزاج الشيء كله. بمجرد أن بدأت التفكير بهذه المصطلحات، توقفت السجلات عن الشعور كأنها خزانة ملفات وبدأت تشبه نظام ذاكرة. ليس أرشيفاً ثابتاً. بل شيئاً أقرب إلى سجل حي للمدخلات التي تستمر في الظهور من جديد داخل الاستدلال.
هذا يجعل جانب المساهم يشعر بأقل شبيهاً بتحميلٍ لمرة واحدة، وأكثر كرهانٍ طويل وغير مؤكد. يمكن إعداد DataNet بشكل جيد ومع ذلك يظل ساكناً. ويمكن أن يكون آخر أكثر فوضوية ويستمر في الظهور لأن النموذج ما زال يعتمد عليه. لست متأكداً إن كان ذلك مقصوداً أو مجرد أثر ناشئ عن التصميم، لكن من الصعب تجاهله.
وهذه هي الجزء الذي أستمر في قلبه. ليست OpenLedger مجرد تقول إن البيانات مهمة. إنها تحاول قياس متى تصبح البيانات مهمة، ثم تحويل هذا القياس إلى ادعاء. هذا يبدو أكثر بنيوية من نظام مكافآت عادي، لأن المكافأة ليست مرتبطة بفعل المساهمة. بل مرتبطة بالتأثير بعد وقوع الأمر.
يبدأ الأمر عندها أن يشعر وكأنه سوق من نوع مختلف تماماً. ليس سوقاً للتخزين. ولا حتى سوقاً للوصول. بل أشبه بسوقٍ للمنفعة المتكررة، حيث يمكن أن تصبح المساهمة نفسها مهمة مرة أخرى كلما مدّ نموذجٌ يده نحوها.
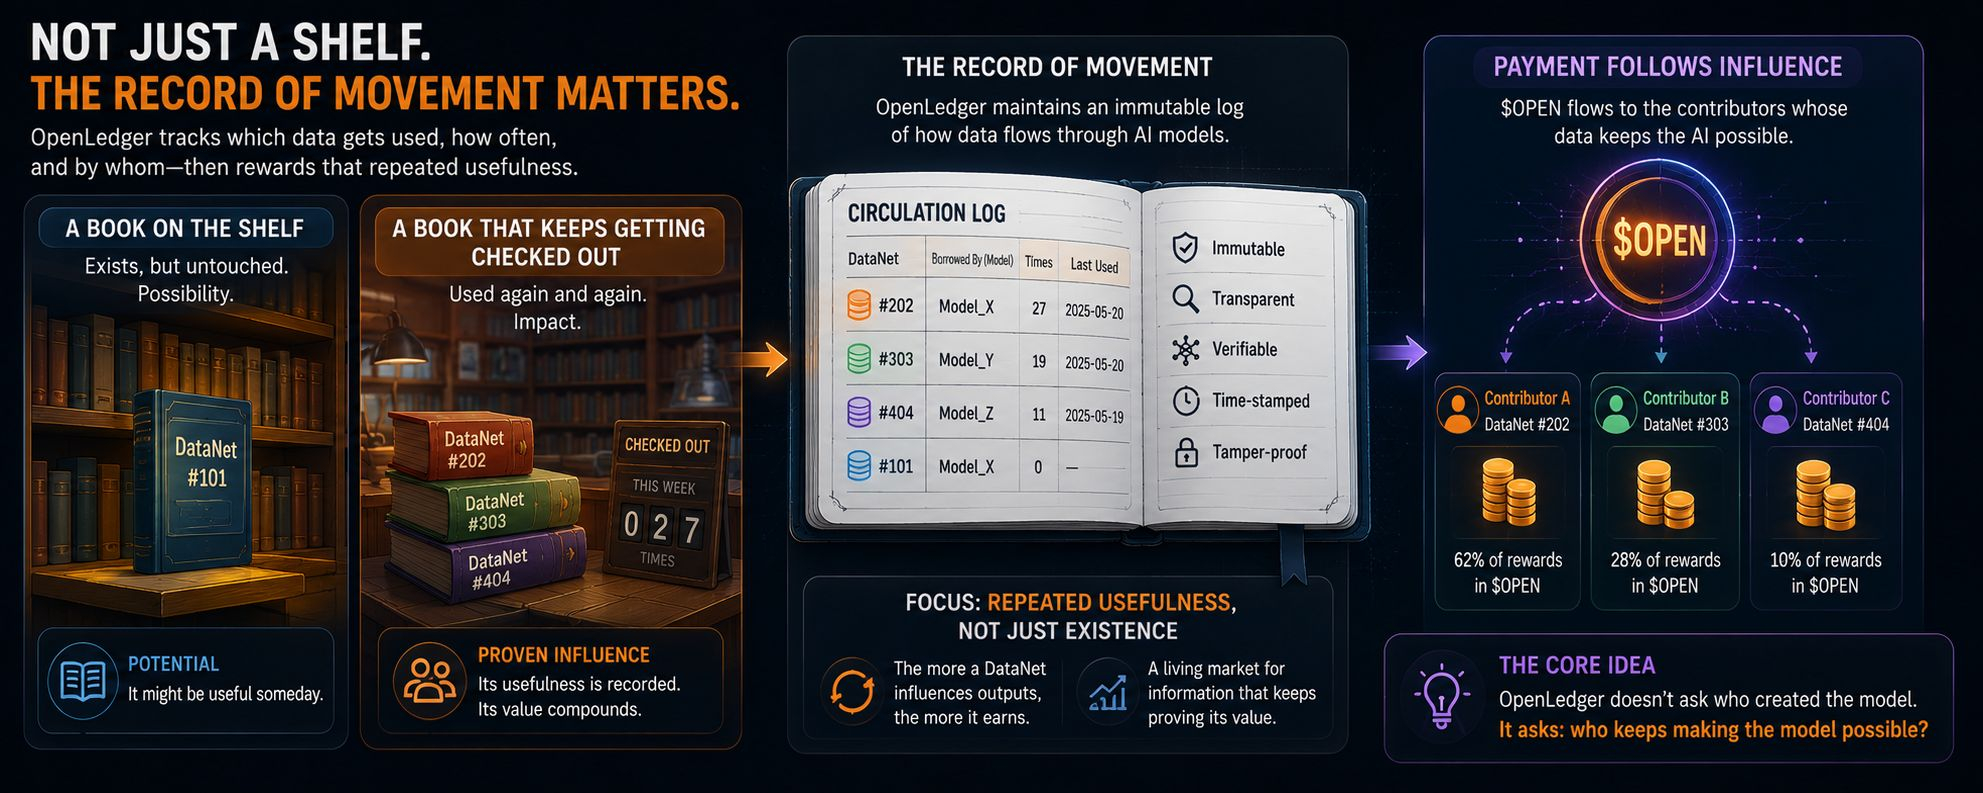
أقرب شيء يمكنني مقارنته به هو مكتب دوران الكتب في مكتبة. كتابٌ على رف شيء. وكتابٌ يستمر في الاقتراض شيء آخر. الرف يهم، لكن سجل الحركة أهم بكثير.
يبدو أن OpenLedger يهتم بالجزء الثاني. يريد معرفة أي أجزاء من المعلومات تستمر في الاقتباس عنها، أو نسخها إلى الداخل، ثم سدادها عبر البروتوكول. إنها فكرة مزعجة أكثر مما تبدو للوهلة الأولى، لأنها تجعل قابلية المنفعة قابلة للقياس بطريقة يمكن الطعن فيها لاحقاً.
ومع ذلك، لا أستطيع تجاهل التوتر بداخله. إذا كانت الإسنادات واسعة جداً، يصبح النظام بأكمله مسرحية. وإذا كانت دقيقة جداً، فسيبدأ الناس في تشكيل DataNets وفقاً لما يمكن تتبعه بشكل نظيف بدلاً من ما يكون مفيداً فعلاً. هذه ليست الشيء نفسه.
هناك أيضاً المشكلة الأصعب المتعلقة بالحجم. نظامٌ كهذا يعتمد على أن تكشف النماذج عن قدرٍ كافٍ من نفسها ليصبح التتبع ذا معنى. إذا صار الناتج مُعمماً جداً، أو إذا صار المسار ضجيجياً للغاية، فقد تضعف حلقة الدفع دون أن يعلن أحد أن ذلك فشل.
أعود دائماً إلى نفس الانزعاج الصغير. تريد OpenLedger أن تجعل البيانات مرئية بما يكفي لتُدفع، لكن ليس مبسطة إلى درجة أن تصبح عملية الدفع مجرد تمثيل. هذا التوازن يبدو هشاً.
ربما لهذا السبب بقيت OpenLedger معي بعد النظرة الأولى. هي ليست حقاً تسأل من بنى النموذج. إنها تسأل من ظل يجعل بناء النموذج ممكناً.
وهذه أسئلة أصعب في تجاهلها.