كنت أعتقد أن مشاكل الثقة في الذكاء الاصطناعي تتعلق بمعدلات الدقة.
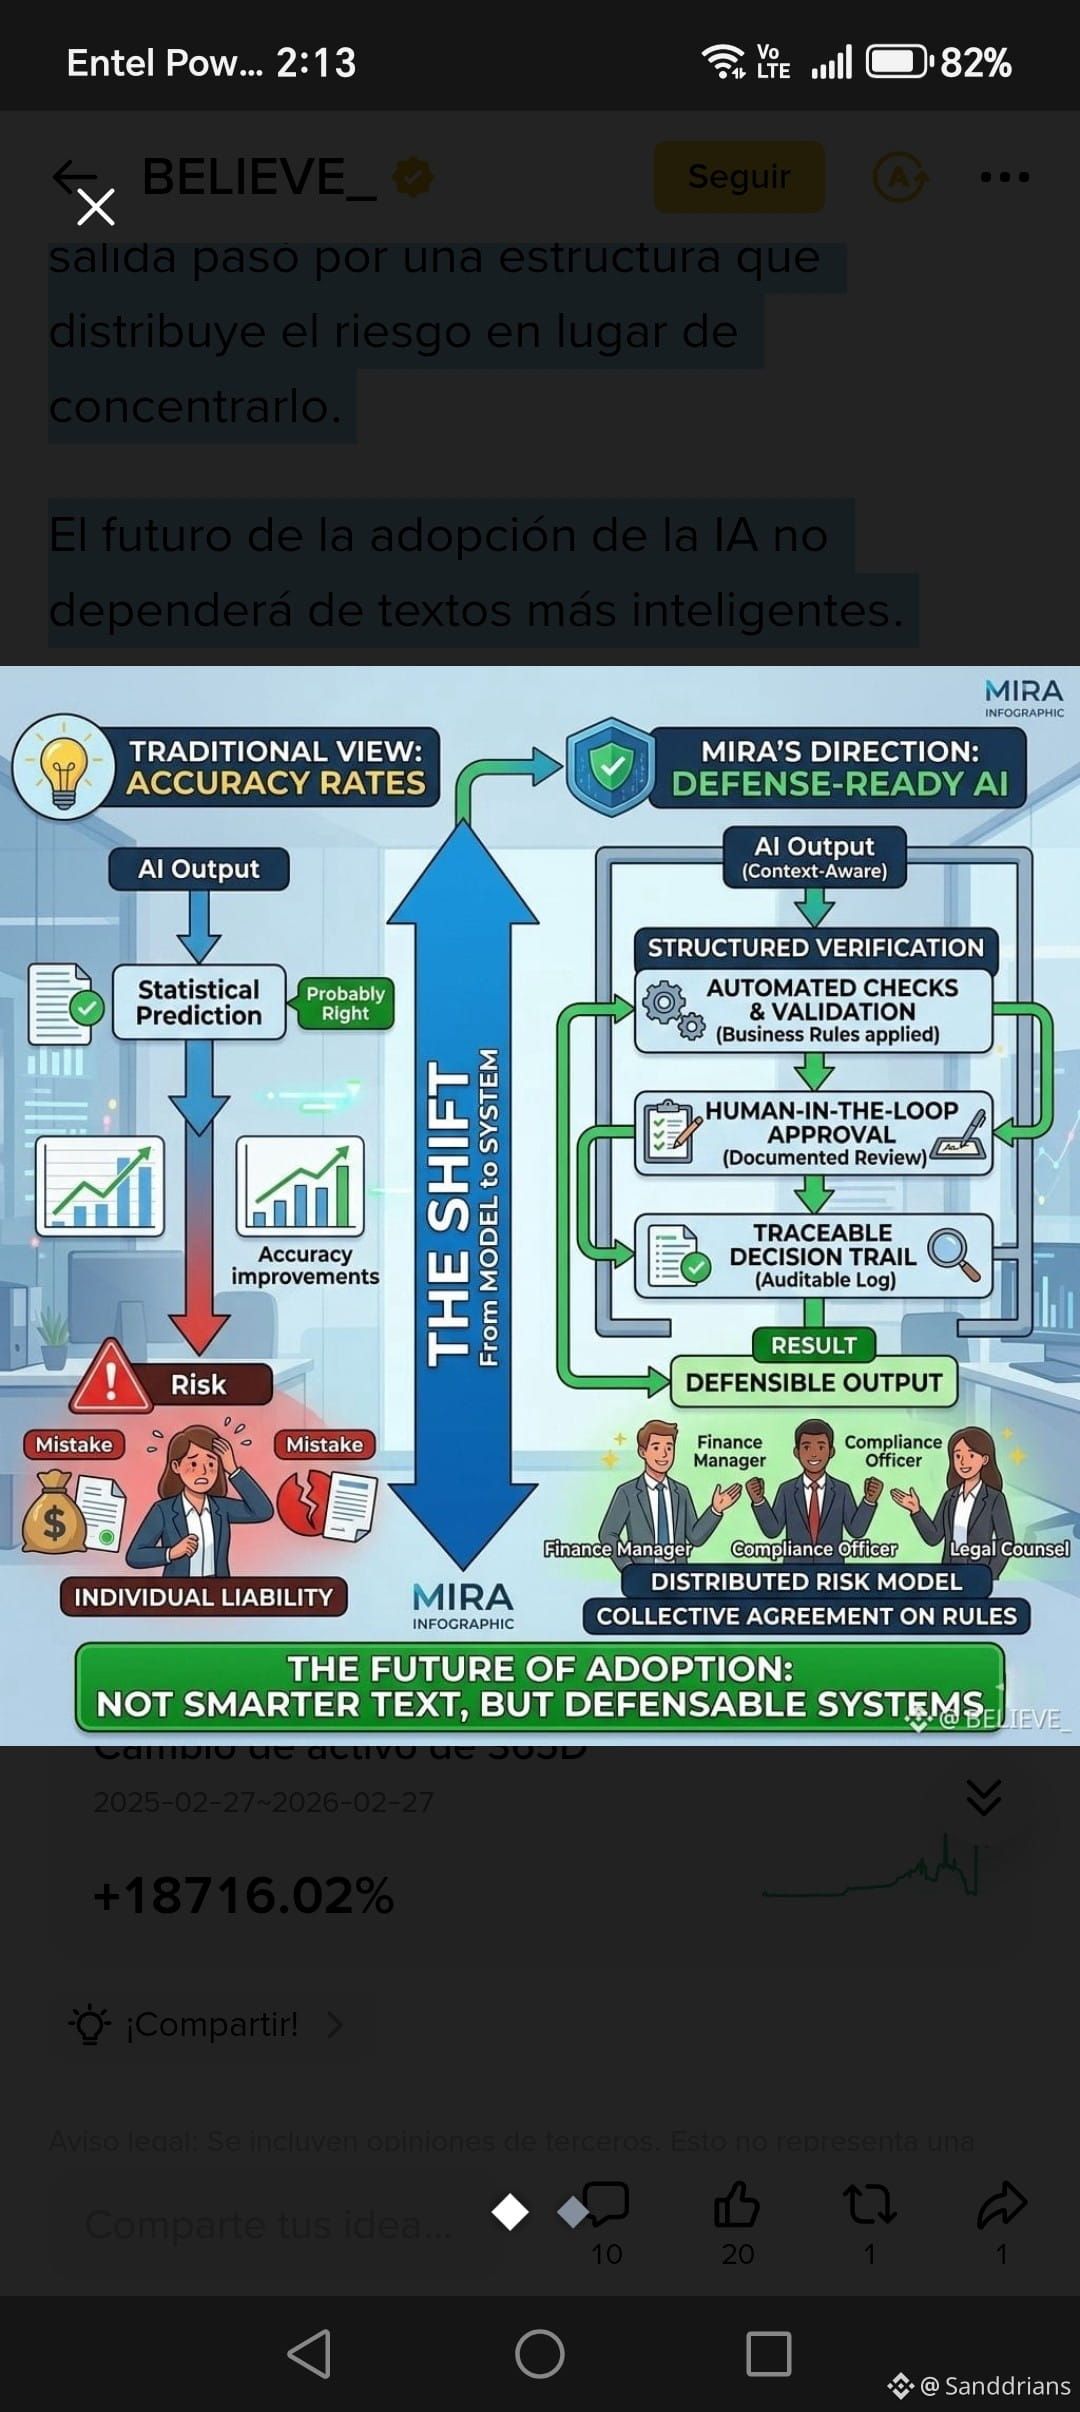
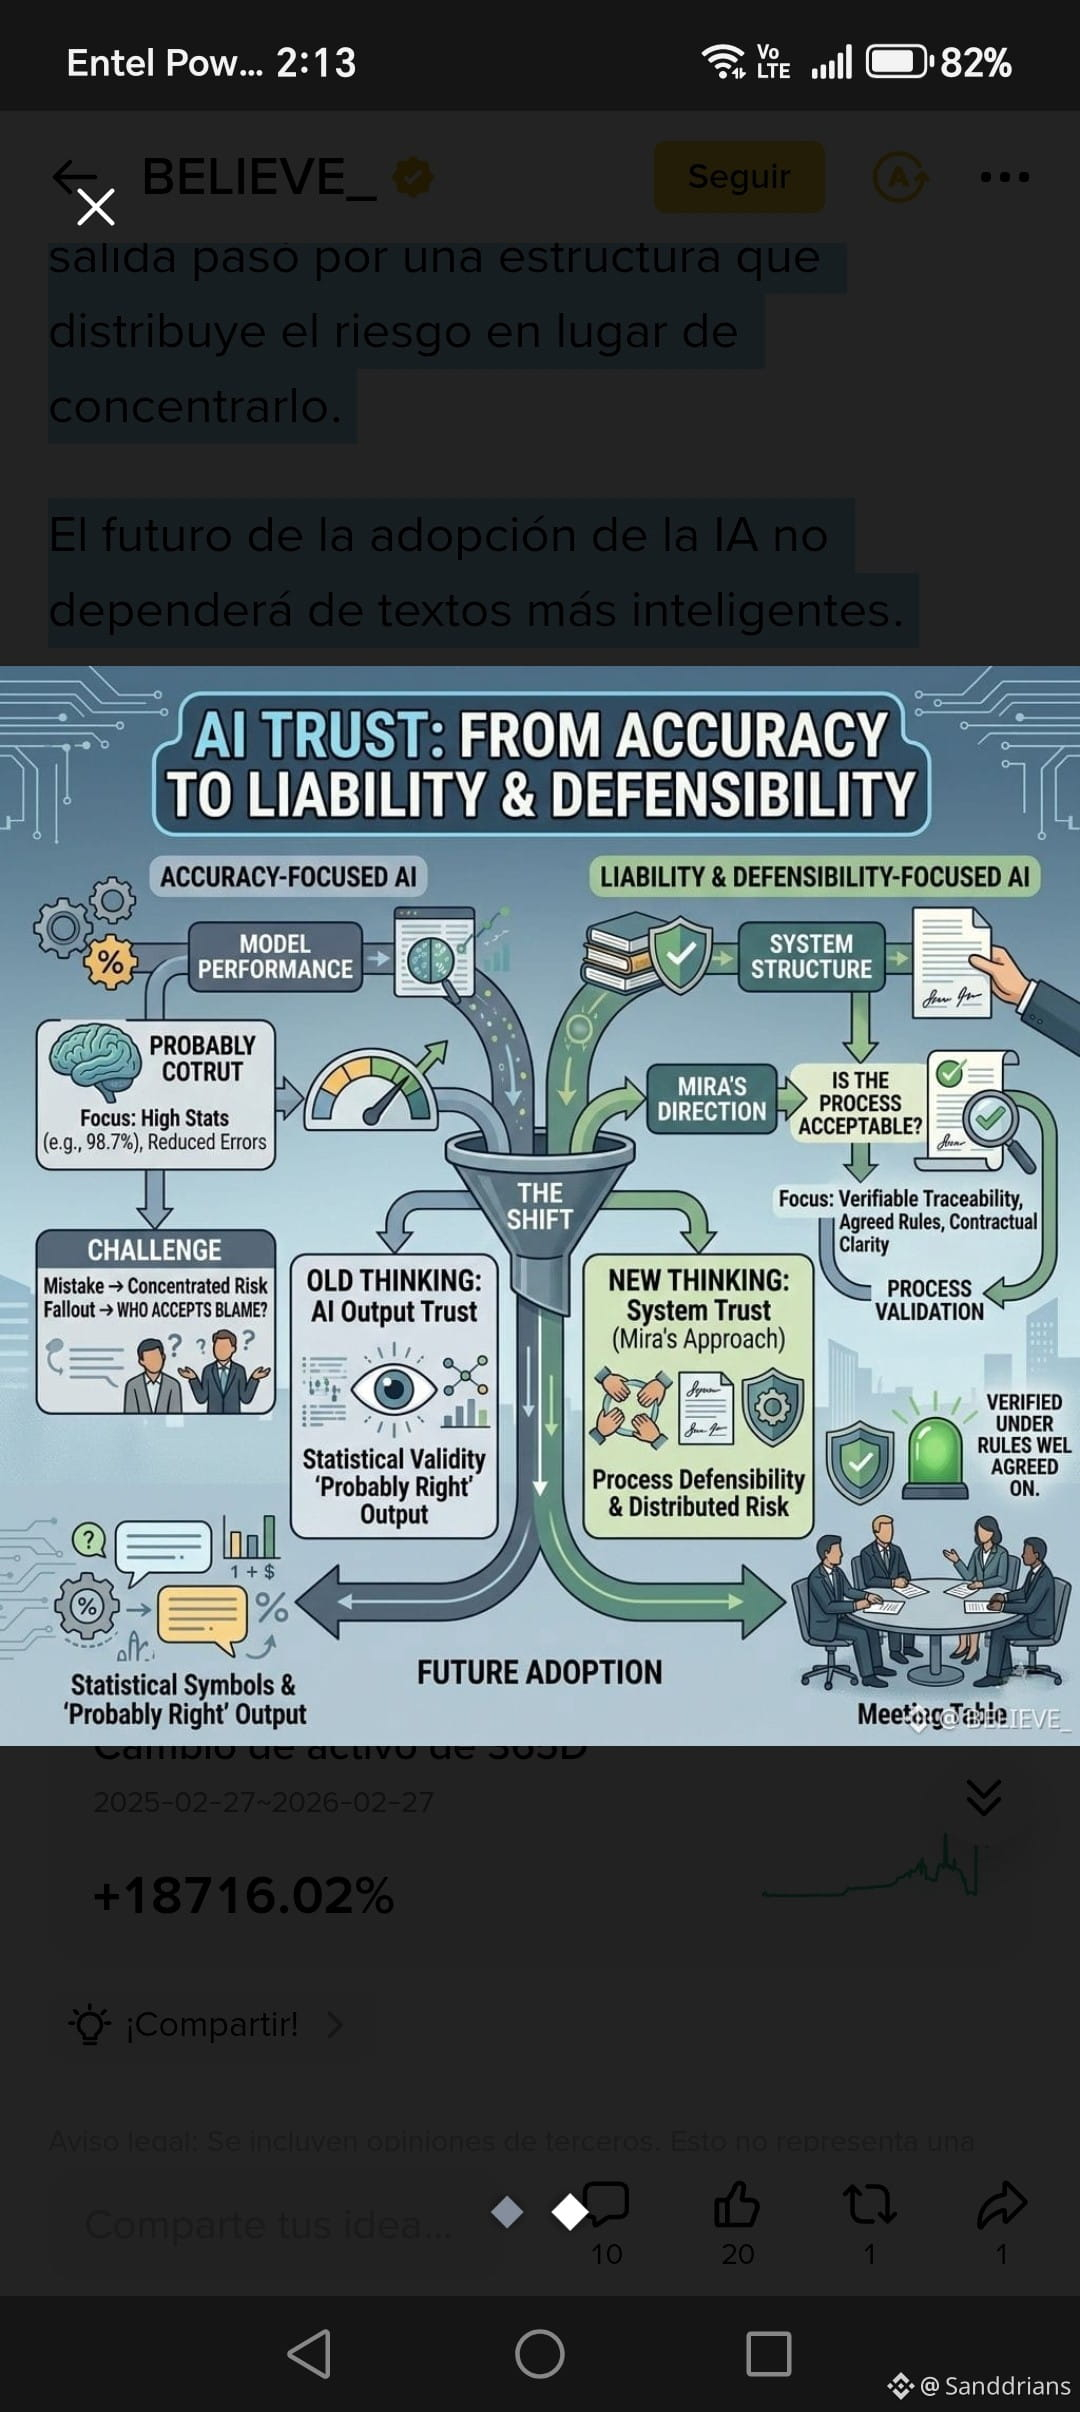
لكن ميرا تجعل الأمر يبدو أكثر كأنه مشكلة مسؤولية.
عندما يرتكب نظام ذكاء اصطناعي خطأ، فإن الضرر ليس إحصائيًا، بل هو تعاقدي. قام شخص ما بالتصرف بناءً على تلك النتيجة. قام شخص ما بالموافقة عليها. شخص ما مسؤول عن العواقب.
ما هو مثير للاهتمام حول اتجاه ميرا هو أنها لا تسأل فقط ما إذا كانت الإجابة صحيحة على الأرجح. تسأل ما إذا كانت عملية قبول تلك الإجابة قابلة للدفاع.
هذا تغيير دقيق ولكنه مهم.
تحسن الدقة النماذج.
تحسن القابلية للدفاع الأنظمة.
مع تقدم الذكاء الاصطناعي نحو التمويل، والامتثال، وتدفقات العمل ذات الأتمتة العالية، فإن "صحيح على الأرجح" لن يكون كافيًا. ما يهم هو ما إذا كانت المخرجات مرت عبر هيكل يوزع المخاطر بدلاً من تركيزها.
لن يعتمد مستقبل اعتماد الذكاء الاصطناعي على نصوص أكثر ذكاءً.
سيعتمد على من يمكنه أن يقول، بثقة،
"تم التحقق من ذلك وفقًا للقواعد التي اتفقنا عليها جميعًا."
@Mira - Trust Layer of AI - Trust Layer of AI#mira $MIRA
لكن ميرا تجعل الأمر يبدو أكثر كأنه مشكلة مسؤولية.
عندما يرتكب نظام ذكاء اصطناعي خطأ، فإن الضرر ليس إحصائيًا، بل هو تعاقدي. قام شخص ما بالتصرف بناءً على تلك النتيجة. قام شخص ما بالموافقة عليها. شخص ما مسؤول عن العواقب.
ما هو مثير للاهتمام حول اتجاه ميرا هو أنها لا تسأل فقط ما إذا كانت الإجابة صحيحة على الأرجح. تسأل ما إذا كانت عملية قبول تلك الإجابة قابلة للدفاع.
هذا تغيير دقيق ولكنه مهم.
تحسن الدقة النماذج.
تحسن القابلية للدفاع الأنظمة.
مع تقدم الذكاء الاصطناعي نحو التمويل، والامتثال، وتدفقات العمل ذات الأتمتة العالية، فإن "صحيح على الأرجح" لن يكون كافيًا. ما يهم هو ما إذا كانت المخرجات مرت عبر هيكل يوزع المخاطر بدلاً من تركيزها.
لن يعتمد مستقبل اعتماد الذكاء الاصطناعي على نصوص أكثر ذكاءً.
سيعتمد على من يمكنه أن يقول، بثقة،
"تم التحقق من ذلك وفقًا للقواعد التي اتفقنا عليها جميعًا."
@Mira - Trust Layer of AI - Trust Layer of AI#mira $MIRA