


تقديم ميزات تعلم آلي دقيقة ومتسقة وجاهزة للإنتاج.
تستكشف هذه القطعة متجر ميزات التعلم الآلي (ML) الخاص بنا بمزيد من التفاصيل. إنه استمرار لمنشور مدونتنا السابق الذي يوفر نظرة عامة أوسع على البنية التحتية لخط أنابيب تعلم الآلة بالكامل.
لماذا نستخدم متجر الميزات؟
يمكن القول إن متجر الميزات، وهو أحد الأجزاء العديدة في خط أنابيبنا، هو أهم ترس في النظام. والغرض الأساسي منه هو العمل كقاعدة بيانات مركزية تدير الميزات قبل شحنها للتدريب النموذجي أو الاستدلال.
إذا لم تكن مألوفًا لهذا المصطلح، فتلخيصًا: الميزات هي في الأساس بيانات خام يتم تنقيحها عبر عملية تُسمى هندسة الميزات لتصبح شيئًا أكثر قابلية للاستخدام يمكن لنماذج تعلم الآلي لدينا استخدامه لتتدرب على نفسها أو لحساب التنبؤات.
باختصار، تتيح لنا مخازن الميزات:
إعادة استخدام ومشاركة الميزات عبر نماذج وفرق مختلفة
تقليل الوقت المطلوب لتجارب التعلم الآلي
تقليل التنبؤات غير الدقيقة بسبب اختلال التزامن بين التدريب والخدمة (training-serving skew) بشكل شديد
لفهم أهمية مخزن الميزات بشكل أفضل، إليك مخططًا لخط تعلم آلي لا يستخدم واحدًا.
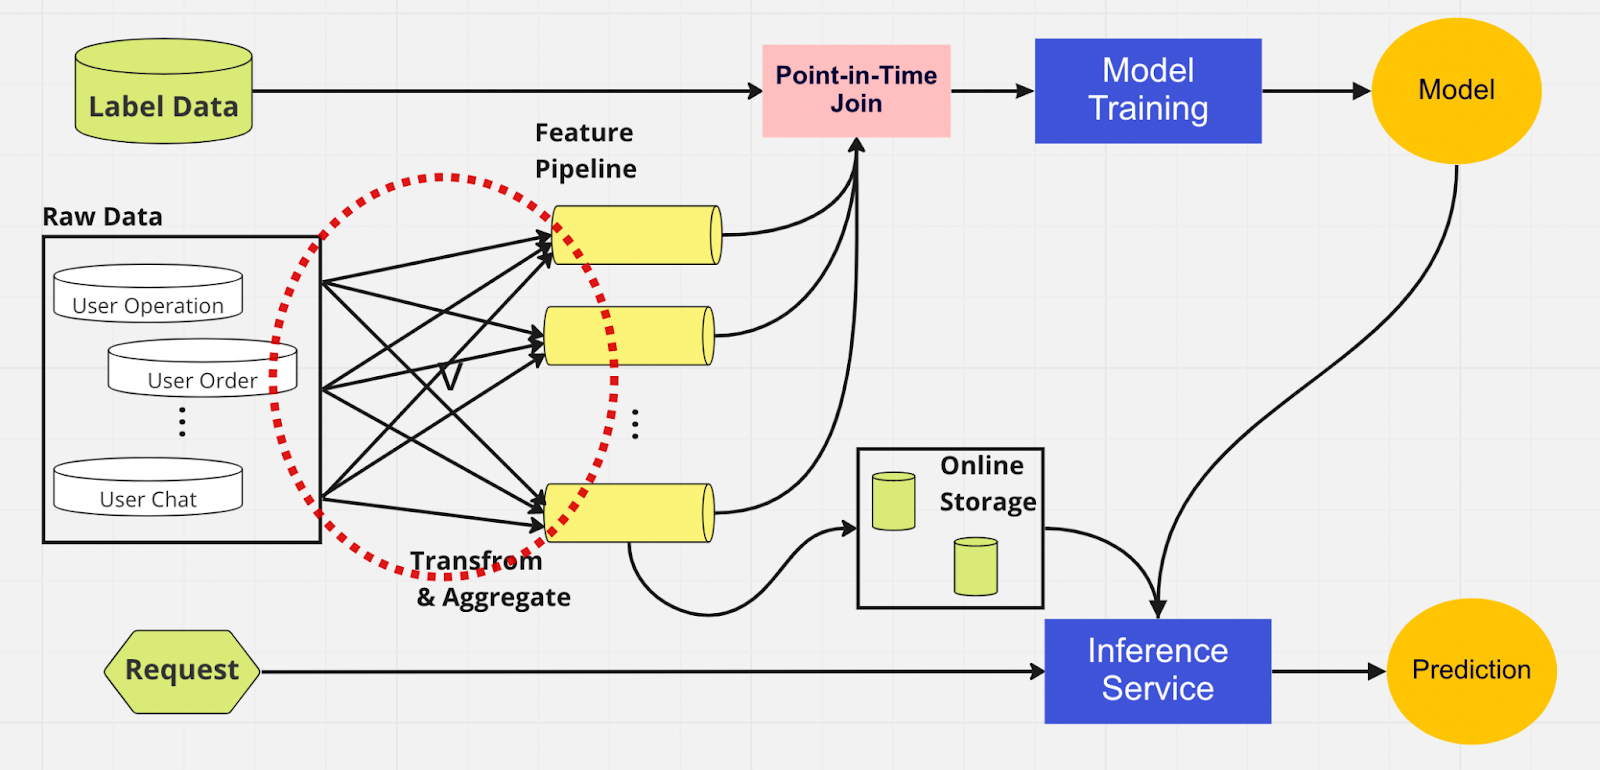
في هذا المسار، لا يمكن الجزآن — تدريب النموذج وخدمة الاستدلال — تحديد الميزات الموجودة مسبقًا وإعادة استخدامها. وهذا يؤدي إلى أن يقوم مسار التعلم الآلي بتكرار عملية هندسة الميزات. ستلاحظ في الدائرة الحمراء بالمخطط أن مسار التعلم الآلي، بدلًا من إعادة استخدام الميزات، قد بنى كتلة من الميزات المكررة وخطوطًا (pipelines) زائدة وغير ضرورية. نطلق على هذه الكتلة اسم تشوّه/انتشار خطوط الميزات (feature pipeline sprawl).
يصبح الحفاظ على هذا الانتشار من الميزات (sprawl) أكثر تكلفة وغير قابل للإدارة كلما نما العمل ودخل مستخدمون أكثر إلى المنصة. فكر في الأمر بهذه الطريقة: يجب على عالم البيانات بدء عملية هندسة الميزات، وهي عملية طويلة ومملة، بالكامل من الصفر لكل نموذج جديد ينشئه.
إضافةً إلى ذلك، فإن إعادة تنفيذ منطق الميزات بشكل كبير جدًا تُدخل مفهومًا يُسمى اختلال التزامن بين التدريب والخدمة (training-serving skew)، وهو اختلاف بين البيانات أثناء مرحلة التدريب ومرحلة الاستدلال. يؤدي ذلك إلى تنبؤات غير دقيقة وسلوك نموذج غير قابل للتنبؤ به يصعب استكشافه أثناء التشغيل في بيئة الإنتاج. قبل مخازن الميزات، كان علماء البيانات لدينا يقومون بالتحقق من اتساق الميزات باستخدام فحوصات التحقق من الصحة (sanity checks). وهذه عملية يدوية تستغرق وقتًا طويلًا تصرف الانتباه عن مهام أكثر أولوية مثل بناء النماذج وهندسة الميزات المفيدة. والآن، دعنا نستكشف مسار تعلم آلي مع مخزن ميزات.
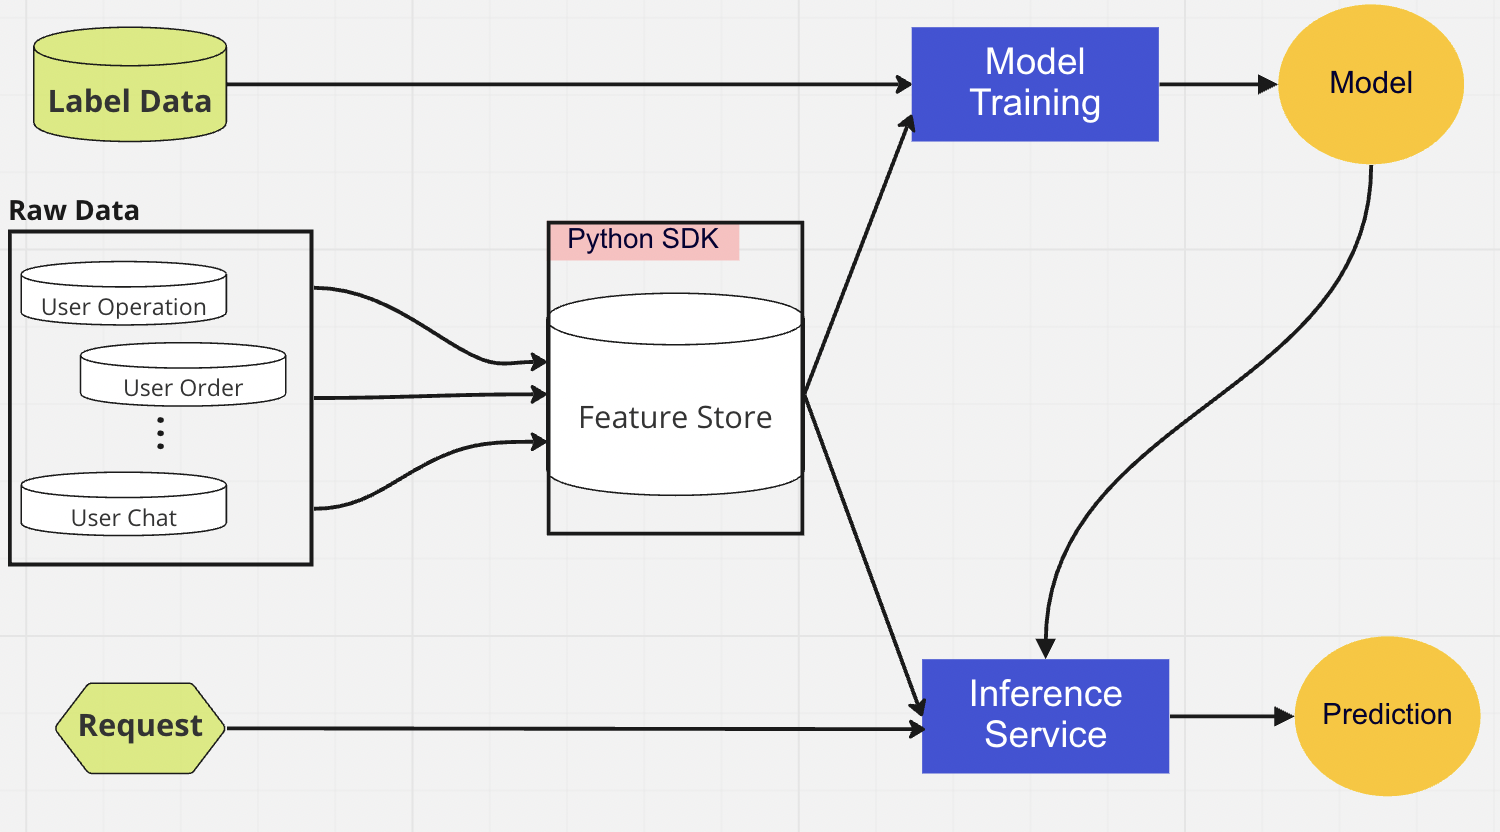
مشابهًا للمسار الآخر، لدينا نفس مصادر البيانات والميزات في الجهة اليسرى. لكن بدلًا من المرور عبر عدة مسارات لهندسة الميزات، لدينا مخزن الميزات كونه مركزًا واحدًا (hub) يخدم المرحلتين من مسار التعلم الآلي (تدريب النموذج وخدمة الاستدلال). لا توجد ميزات مكررة؛ فكل العمليات المطلوبة لبناء ميزة، بما في ذلك التحويل والتجميع، تحتاج إلى التنفيذ مرة واحدة فقط.
يمكن لعلماء البيانات التفاعل مع مخزن الميزات بشكل بديهي باستخدام حزمة تطوير بايثون (Python SDK) الخاصة بنا للبحث وإعادة الاستخدام واكتشاف الميزات لتدريب النماذج وتدعيم الاستدلال في اتجاهات التعلم الآلي اللاحقة.
بشكل أساسي، يعد مخزن الميزات قاعدة بيانات مركزية يوحِّد المرحلتين معًا. وبما أن مخزن الميزات يضمن ميزات متسقة للتدريب والاستدلال، فيمكننا تقليل اختلال التزامن بين التدريب والخدمة بشكل كبير.
لاحظ أن مخازن الميزات تقدم أكثر بكثير مما ذكرناه أعلاه. وبالطبع، فهذا مجرد تلخيص أبسط لسبب استخدامنا لمخزن الميزات، ويمكن تفكيكه أكثر إلى بضع كلمات فقط: تجهيز وإرسال الميزات إلى نماذج تعلم الآلي بأسرع الطرق وأسهلها الممكنة.
داخل مخزن الميزات (Feature Store)

يُظهر الشكل أعلاه التخطيط المعتاد لمخزن الميزات لديك، سواء كان AWS SageMaker Feature Store أو Google Vertex AI (Feast) أو Azure (Feathr) أو Iguazio أو Tetcom. توفر جميع مخازن الميزات نوعين من التخزين: عبر الإنترنت (online) أو خارج الإنترنت (offline).
تُستخدم مخازن الميزات عبر الإنترنت للاستدلال في الوقت الحقيقي، بينما تُستخدم مخازن الميزات خارج الإنترنت للتنبؤات الدفعية وتدريب النماذج. وبسبب حالات الاستخدام المختلفة، فإن المقياس الذي نستخدمه لتقييم الأداء يختلف تمامًا. في مخزن الميزات عبر الإنترنت، نبحث عن زمن استجابة منخفض. أما في مخازن الميزات خارج الإنترنت، فنحن نريد إنتاجية (throughput) عالية.
يمكن للمطورين اختيار أي مخزن ميزات مؤسسي أو حتى مخزن مفتوح المصدر اعتمادًا على مجموعة التقنيات (tech stack). يوضح المخطط أدناه الاختلافات الرئيسية بين المخازن عبر الإنترنت وخارج الإنترنت في AWS SageMaker Feature Store.

مخزن عبر الإنترنت: يخزن أحدث نسخة من الميزات ويخدمها بزمن كمون منخفض بالميلي ثانية، وتعتمد السرعة على حجم الحمولة (payload). بالنسبة لنموذج الاستحواذ على الحساب (ATO) الذي يحتوي على ثماني مجموعات ميزات و55 ميزة إجمالًا، فإن السرعة تكون حوالي 30 مللي ثانية كزمن p99.
مخزن خارج الإنترنت: مخزن لا يسمح بالتعديل (append-only) يتيح لك تتبع جميع الميزات التاريخية وتمكين “السفر عبر الزمن” (time travel) لتجنب تسرب البيانات. تُخزَّن البيانات بصيغة parquet مع تقسيم حسب الوقت لزيادة كفاءة القراءة.
بالنسبة لاتساق الميزات، طالما تم تهيئة مجموعة الميزات للاستخدام في كل من الوضع عبر الإنترنت وخارج الإنترنت، فسيتم نسخ البيانات تلقائيًا وداخليًا إلى مخزن خارج الإنترنت أثناء تحميل الميزة بواسطة المخزن عبر الإنترنت.
كيف نستخدم مخزن الميزات؟

يخفي الرمز المصوَّر أعلاه تعقيدًا كبيرًا. تتيح لنا ميزات التخزين (Feature Stores) استيراد واجهة بايثون بسهولة للتدريب والاستدلال باستخدام النموذج.
باستخدام ميزة التخزين (Feature Store)، يستطيع علماء البيانات لدينا تحديد الميزات بسهولة وبناء نماذج جديدة دون الحاجة للقلق بشأن عملية هندسة البيانات المتعبة في الخادم الخلفي.
أفضل الممارسات لاستخدام مخزن الميزات (Feature Store)
في منشورنا السابق، شرحنا كيف نستخدم طبقة وسيطة (store layer) لتدفق الميزات إلى قاعدة البيانات المركزية. وهنا نود مشاركة أفضل ممارستين عند استخدام مخزن الميزات:
لا نقوم بتحميل ميزات لم تتغير
نُقسِّم الميزات إلى مجموعتين منطقيتين: عمليات المستخدم النشط وغير النشط
فكّر في هذا المثال. لنفترض أن لديك حد اختناق (throttling) يبلغ 10K TPS لعملية PutRecord في مخزن الميزات عبر الإنترنت. وبناءً على هذا الافتراض، سنُحمِّل الميزات لـ 100 مليون مستخدم. لا يمكننا تحميلها كلها مرة واحدة، ووفق سرعتنا الحالية سيستغرق الأمر حوالي 2.7 ساعة لإتمام ذلك. ولحل هذه المشكلة، نختار فقط تحميل الميزات التي تم تحديثها مؤخرًا. على سبيل المثال، لن نقوم بتحميل ميزة إذا كانت قيمة تلك الميزة لم تتغير منذ آخر مرة تم تحميلها.
بالنسبة للنقطة الثانية، لِنفترض أنك وضعت مجموعة من الميزات في مجموعة ميزات منطقية واحدة. بعضها يكون نشطًا، بينما تكون نسبة كبيرة غير نشطة، ما يعني أن معظم الميزات لم تتغير. والخطوة المنطقية، في رأينا، هي تقسيم الميزات النشطة وغير النشطة إلى مجموعتين ميزات منفصلتين لتسريع عملية التحميل.
بالنسبة للميزات غير النشطة، نُقلِّل 95% من البيانات التي نحتاج إلى تحميلها إلى مخزن الميزات لعدد 100 مليون مستخدم ضمن ساعة في خط أنابيب الميزات (feature pipeline). بالإضافة إلى ذلك، ما زلنا نُقلِّل 20% من البيانات المطلوبة للميزات النشطة. لذلك، بدلًا من ثلاث ساعات، يقوم خط أنابيب التحميل الدفعي بمعالجة ميزات تساوي 100 مليون مستخدم خلال 10 دقائق.
خلاصات ختامية
للخلاصة، تتيح لنا مخازن الميزات إعادة استخدام الميزات وتسريع هندسة الميزات وتقليل التنبؤات غير الدقيقة — مع الحفاظ في الوقت نفسه على الاتساق بين التدريب والاستدلال.
هل أنت مهتم باستخدام التعلم الآلي لحماية أكبر نظام بيئي للعملات الرقمية المشفرة في العالم ومستخدميه؟ تفقّد Binance Engineering/AI على صفحة الوظائف لدينا للحصول على إعلانات وظائف شاغرة.
قراءة إضافية:
(مدونة) استخدام MLOps لبناء مسار تعلم آلي كامل لحظي من البداية إلى النهاية