لقد أعِدتُ مؤخرًا فهم KGeN: لعلّ ما ينقص الذكاء الاصطناعي ليس المزيد من البيانات فعلًا
أثناء بحثي في KGeN، كان أكبر ما شعرتُ به هو: كلما زادت البيانات لدى الذكاء الاصطناعي، قد تصبح مسألة ما إذا كانت هذه البيانات «صادرة فعلًا عن البشر» أكثر أهمية.
في السابق، عندما كنتُ أرى مشاريع ذكاء اصطناعي تتحدث عن البيانات، لم أكن عادةً أتوقف عند ذلك طويلًا. فاليوم على الإنترنت توجد كل أنواع البيانات.
لكن المشكلة تكمن هنا بالذات.
توجد الآن مقالات وصور وأصوات مولّدة بالذكاء الاصطناعي أكثر فأكثر، كما أصبحت حسابات الروبوتات أكثر شيوعًا. فهل سيحدث حلقة مفرغة في المستقبل إذا تعلّم الذكاء الاصطناعي بكميات كبيرة محتوى تم توليده أصلًا بواسطة ذكاء اصطناعي؟
ذكاء اصطناعي مُولِّد → ذكاء اصطناعي مُتعلِّم → توليد مرة أخرى → تدريب مرة أخرى للذكاء الاصطناعي.
تزداد الكمية، لكن ربما يقل عدد التجارب البشرية الحقيقية.
وهذا أيضًا هو السبب الذي جعلني أبدأ بالنظر بجدية إلى KGeN.
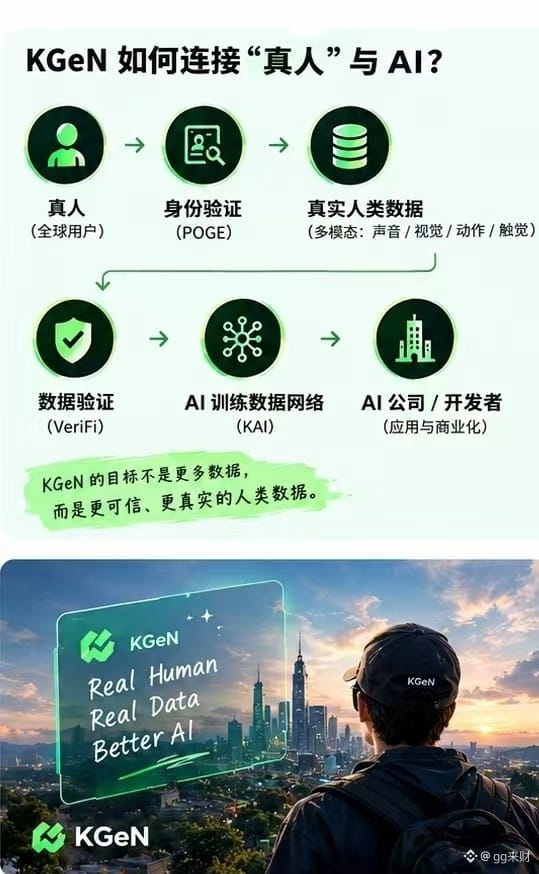
يُعرّف KGeN حاليًا نفسه بأنه Verified Human Network (شبكة البشر المُتحققين منها). يتمثل الاتجاه الأساسي في الحصول على بيانات متعددة الوسائط حقيقية من البشر تم التحقق منها، لاستخدامها في Physical AI وLLM. وذكر الموقع الرسمي أن أنواع البيانات تشمل الصوت والرؤية والحركة واللمس، كما أنها تغطي 60+ دولة.
أعتقد أن أكثر ما يستحق التفكير هنا ليس مفهوم «الذكاء الاصطناعي» الرائج بحد ذاته، بل:
إذا كان على الذكاء الاصطناعي في المستقبل أن يفهم العالم الواقعي حقًا، فهل يجب عليه أولًا أن يفهم البشر الحقيقيين؟
فعلى سبيل المثال، لكي يتعلم روبوت العيش في بيئة حقيقية، قد لا يكفي مجرد مشاهدة صور من الإنترنت.
هو يحتاج إلى معرفة كيفية حديث الناس، وكيف يتحركون، وكيف يلاحظون البيئة، بل وحتى كيف تكون ردود أفعال البشر في سيناريوهات مختلفة.
عندها لم تعد بيانات البشر الحقيقيين مجرد مسألة «كمية البيانات»، بل أصبحت مسألة «مصدر البيانات وجودتها».
فكرة KGeN حاليًا هي ربط البشر الحقيقيين، مع التحقق، ومع بيانات متعددة الوسائط، واحتياجات تدريب الذكاء الاصطناعي. ويشمل نظام منتجاته أيضًا K-Quest، حيث يتم جمع البيانات متعددة الوسائط اللازمة لـ Physical AI وLLM عبر قيام بشر حقيقيين مُتحققين بإكمال مهام.
وبالطبع، لن أقول الآن إن KGeN سيَنجح بالتأكيد.
بالنسبة لي، ما يستحق المتابعة أكثر هو:
هل يمكن أن يستمر نمو المستخدمين الحقيقيين؟
هل يمكن أن تستمر احتياجات توليد البيانات؟
هل يمكن استخدام هذه البيانات فعليًا من قِبل شركات الذكاء الاصطناعي؟
وأخيرًا، هل يمكن أن يتشكل حلقة تجارية طويلة الأمد؟
هذه الأسئلة أكثر إثارة للاهتمام من مجرد النظر إلى الأسعار على المدى القصير.
لا يزال لديّ المزيد لأراقبه
#KGen