شيء ما برز خلال المهمة لم أتوقع أن أجده - ويعيد تشكيل زاوية الامتثال بالكامل.
OpenGradient $OPG @OpenGradient #OPG تضع نفسها كذكاء اصطناعي صديق للامتثال من خلال إثبات تشفير لكل استنتاج: أي نموذج تم تشغيله، وما هي البيانات التي تلامست معه، أثر غير قابل للتغيير على السلسلة. بالنسبة للصناعات المنظمة - الخدمات المالية، الرعاية الصحية، أي مكان يحتاج فيه قرار الذكاء الاصطناعي إلى مسار تدقيق - فإن هذا هيكل مقنع حقًا.
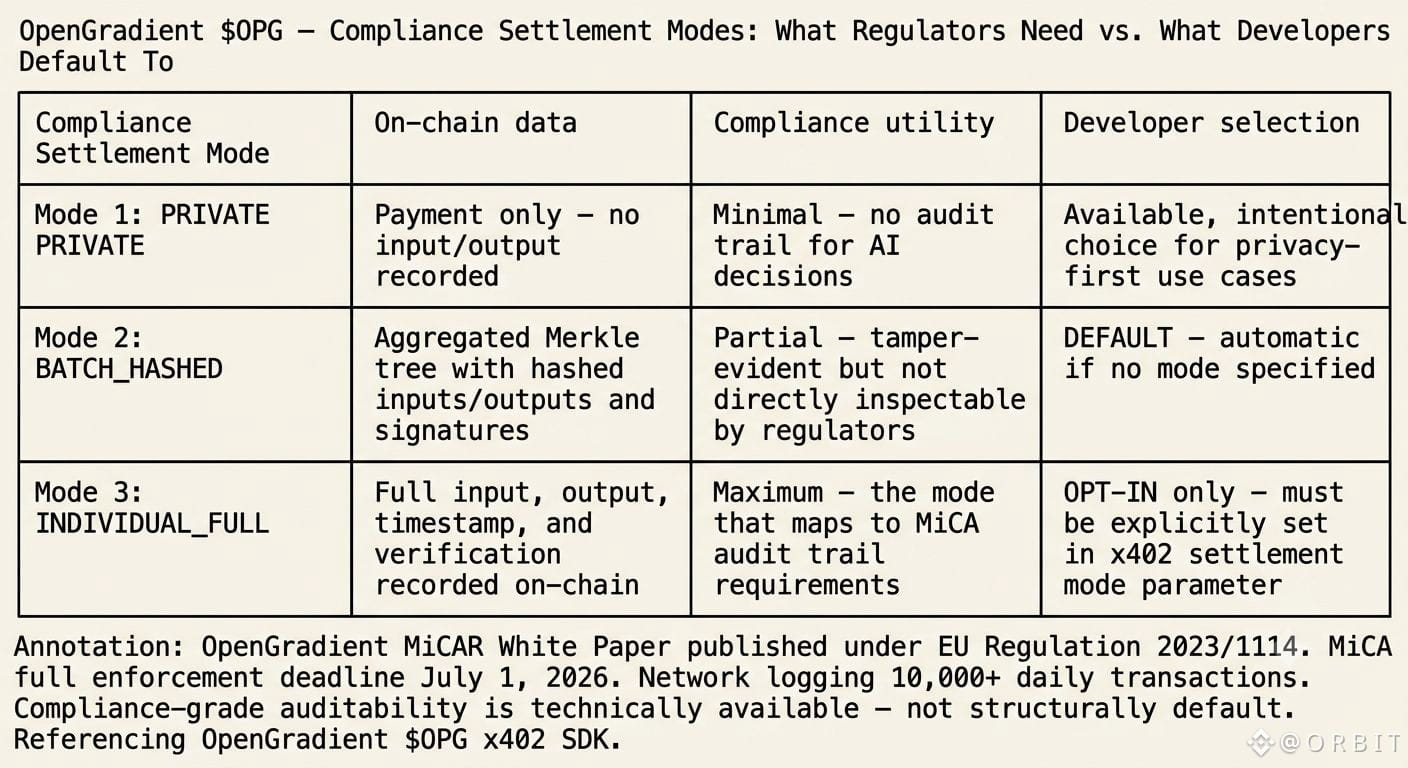
ولكن عند التعمق في SDK تسوية x402 الفعلي، هناك ثلاثة أوضاع. PRIVATE: دفع فقط، صفر بيانات على السلسلة. BATCH_HASHED: تجميعات مشفرة في شجرة ميركل، فعّالة من حيث التكلفة - وهي الوضع الافتراضي. INDIVIDUAL_FULL: الإدخال الكامل، المخرجات، الطابع الزمني، والتحقق المسجل على السلسلة. هذا الأخير هو مسار الامتثال الذي يرغب فيه المنظمون فعليًا. إنه ليس الوضع الافتراضي. يجب على المطور الذي يبني تطبيقًا متوافقًا أن يختار ذلك بوعي.
استمررت في التفكير في هذا. يوجد ورقة بيضاء لمبادرة MiCA الخاصة بـ OpenGradient - تصنيف تنظيمي كامل بموجب لائحة الاتحاد الأوروبي 2023/1114 - مما يظهر أنهم يفكرون بجدية في سوق الامتثال تمامًا كما تنتهي فترة الانتقال لمبادرة MiCA في 1 يوليو 2026 ويصبح التنفيذ أكثر صرامة عبر دول الاتحاد الأوروبي. سجلت الشبكة أكثر من 10,000 معاملة يومية هذا الأسبوع في ظل هذا السياق. لكن قصة الامتثال على مستوى الشبكة وسلوك الوضع الافتراضي على مستوى المطور لا تزال تسحب في اتجاهات مختلفة.
هل يتطلب الامتثال فعلاً بنية تحتية تجعل إمكانية التدقيق الوضع الافتراضي بدلاً من وضع قابل للاختيار؟